Hashes em Ruby: Um Guia Visual e Prático
Aprenda hashes em Ruby de forma visual: pares chave-valor, chaves símbolo vs. string, ler com segurança com fetch e dig, valores padrão para contar e agrupar, percorrer e transformar, argumentos nomeados, medições reais e exercícios com respostas.

Nesta página
Uma agenda liga nomes a telefones. Um dicionário liga palavras a significados. A lista de estoque de uma loja liga produtos a quantidades. Sempre que você quer achar algo por um nome em vez de por uma posição, você quer um hash.
Hashes estão em todo lugar no Ruby: configurações, JSON vindo de APIs da web, contagens, agrupamentos e os registros dentro de quase todo array. Neste guia você vai ver como um hash funciona, ler dele com segurança, contar e agrupar com valores padrão, escapar da armadilha de símbolo vs. string, cavar em dados aninhados, passar opções com argumentos nomeados e medir o quanto as buscas são rápidas de verdade. Exercícios com respostas fecham o artigo.
Todas as saídas abaixo vêm de execuções reais com o Ruby 3.3.
Um gaveteiro com etiquetas

Um hash guarda pares chave-valor. A chave é a etiqueta; o valor é o que está dentro. Outras linguagens chamam a mesma ideia de dicionário (Python), mapa (Java, Go) ou objeto (JavaScript).
1tarefas = {}
2tarefas[:segunda] = "lavar a louça"
3tarefas[:quarta] = "treino de caratê"
4p tarefas
5
6capitais = { "França" => "Paris", "Japão" => "Tóquio", "Brasil" => "Brasília" }
7p capitais
8
9pessoa = { nome: "Ada", nascimento: 1815, idiomas: ["inglês", "francês"] }
10p pessoa
11p pessoa.size1{:segunda=>"lavar a louça", :quarta=>"treino de caratê"}
2{"França"=>"Paris", "Japão"=>"Tóquio", "Brasil"=>"Brasília"}
3{:nome=>"Ada", :nascimento=>1815, :idiomas=>["inglês", "francês"]}
43Existem dois jeitos de escrever os pares:
chave => valor(o "foguete") funciona com qualquer tipo de chave: strings, números, símbolos, até arrays.chave: valoré um atalho que só funciona para chaves símbolo:{ nome: "Ada" }quer dizer exatamente{ :nome => "Ada" }.
Os valores podem ser qualquer coisa, inclusive arrays e outros hashes.
Array ou hash?

Use um array quando tiver uma lista em que a ordem importa. Use um hash quando cada valor tiver um nome pelo qual você vai procurá-lo.
Lendo valores
1tarefas = { segunda: "lavar a louça", quarta: "treino de caratê" }
2p tarefas[:segunda]
3p tarefas[:sexta]
4p tarefas.fetch(:segunda)
5p tarefas.fetch(:sexta, "nada planejado")
6p tarefas.fetch(:sexta) { |dia| "nada na #{dia}" }
7p tarefas.key?(:segunda)
8p tarefas.value?("treino de caratê")
9p tarefas.keys
10p tarefas.values1"lavar a louça"
2nil
3"lavar a louça"
4"nada planejado"
5"nada na sexta"
6true
7true
8[:segunda, :quarta]
9["lavar a louça", "treino de caratê"]Quando a chave não existe

Os colchetes dão nil para uma chave que não existe. O fetch se recusa, em voz alta:
tarefas = { segunda: "lavar a louça" }
tarefas.fetch(:sexta)
erro_fetch.rb:2:in `fetch': key not found: :sexta (KeyError)
from erro_fetch.rb:2:in `<main>'("Chave não encontrada: :sexta.") Qual é melhor? Depende de a chave faltando ser normal ou um engano:
- Se faltar a chave é normal ("nada na sexta"), use
[]oufetchcom um valor reserva. - Se faltar a chave quer dizer que algo deu errado (uma configuração obrigatória, uma chave digitada errado), use
fetch. Onildo[]costuma viajar pelo programa e estourar em algum lugar bem longe, o que é muito mais difícil de depurar.
Acrescentando, mudando e tirando
1estoque = { macas: 10, bananas: 6 }
2estoque[:cerejas] = 25
3estoque[:macas] = 8
4p estoque
5
6tirado = estoque.delete(:bananas)
7puts "Tirei as bananas (eram #{tirado})"
8p estoque
9
10mais = estoque.merge(tamaras: 12, macas: 30)
11p mais
12p estoque1{:macas=>8, :bananas=>6, :cerejas=>25}
2Tirei as bananas (eram 6)
3{:macas=>8, :cerejas=>25}
4{:macas=>30, :cerejas=>25, :tamaras=>12}
5{:macas=>8, :cerejas=>25}- Atribuir a uma chave que já existe substitui o valor dela; uma chave nova é acrescentada. Um hash nunca tem a mesma chave duas vezes.
- O
deletetira um par e devolve o valor dele. - O
mergedevolve um hash novo com os dois juntos, e o segundo hash ganha quando as chaves se repetem. (Omerge!muda o original.) - Os hashes do Ruby lembram a ordem em que as chaves foram acrescentadas.
Percorrendo um hash
1precos = { cafe: 3.5, bolo: 4.25, suco: 4.0, sanduiche: 7.0 }
2
3precos.each do |item, preco|
4  puts "#{item.to_s.ljust(10)} #{format('%.2f', preco)}"
5end
6
7p precos.sum { |item, preco| preco }
8p precos.select { |item, preco| preco >= 4 }
9p precos.reject { |item, preco| preco >= 4 }
10p precos.min_by { |item, preco| preco }
11p precos.sort_by { |item, preco| -preco }.first(2)
12p precos.transform_values { |preco| (preco * 1.1).round(2) }
13p precos.map { |item, preco| "#{item}: #{preco}" }
14p precos.to_a.first1cafe 3.50
2bolo 4.25
3suco 4.00
4sanduiche 7.00
518.75
6{:bolo=>4.25, :suco=>4.0, :sanduiche=>7.0}
7{:cafe=>3.5}
8[:cafe, 3.5]
9[[:sanduiche, 7.0], [:bolo, 4.25]]
10{:cafe=>3.85, :bolo=>4.68, :suco=>4.4, :sanduiche=>7.7}
11["cafe: 3.5", "bolo: 4.25", "suco: 4.0", "sanduiche: 7.0"]
12[:cafe, 3.5]O bloco recebe dois parâmetros, a chave e o valor. O select e o reject devolvem hashes; o transform_values muda cada valor e mantém as chaves. O map, o min_by e o sort_by tratam o hash como uma lista de pares [chave, valor].
Valores padrão: contando e agrupando

Contando com Hash.new(0)
1texto = "o gato e o rato e o pato"
2
3contagem = Hash.new(0)
4texto.split.each { |palavra| contagem[palavra] += 1 }
5p contagem
6p contagem["cão"]
7p contagem
8
9p texto.split.tally1{"o"=>3, "gato"=>1, "e"=>2, "rato"=>1, "pato"=>1}
20
3{"o"=>3, "gato"=>1, "e"=>2, "rato"=>1, "pato"=>1}
4{"o"=>3, "gato"=>1, "e"=>2, "rato"=>1, "pato"=>1}Com Hash.new(0), uma chave que não existe vale 0, então contagem[palavra] += 1 funciona até na primeira vez que a palavra aparece. Ler uma chave que não existe não a acrescenta: contagem["cão"] é 0, mas o hash não muda. (Para só contar, o tally faz tudo de uma vez.)
Agrupando com um bloco
1alunos = [["Ana", "A"], ["Bruno", "B"], ["Carla", "A"], ["Davi", "C"], ["Eva", "B"]]
2
3por_conceito = Hash.new { |hash, conceito| hash[conceito] = [] }
4alunos.each { |nome, conceito| por_conceito[conceito] << nome }
5p por_conceito
6
7p alunos.group_by { |nome, conceito| conceito }.transform_values { |pares| pares.map(&:first) }
{"A"=>["Ana", "Carla"], "B"=>["Bruno", "Eva"], "C"=>["Davi"]}
{"A"=>["Ana", "Carla"], "B"=>["Bruno", "Eva"], "C"=>["Davi"]}O bloco roda sempre que uma chave que não existe é lida e, aqui, ele guarda um array vazio novinho naquela chave.
A armadilha: Hash.new([])
Parece que faria a mesma coisa. Não faz:
1por_conceito = Hash.new([])
2por_conceito["A"] << "Ana"
3por_conceito["B"] << "Bruno"
4p por_conceito
5p por_conceito["Z"]
{}
["Ana", "Bruno"]O hash continua vazio, e toda chave que não existe devolve o mesmo array único, que agora tem os dois nomes. O << mudou o array padrão compartilhado e nunca guardou nada no hash. É a mesma armadilha do Array.new(3, []) do artigo sobre arrays. Use a forma com bloco sempre que o padrão for um array, um hash ou uma string que você vai mudar.
Chaves símbolo vs. chaves string

1config = { "volume" => 7 }
2p config[:volume]
3p config["volume"]
4
5require "json"
6salvo = JSON.generate({ volume: 7, tema: "escuro" })
7p salvo
8p JSON.parse(salvo)
9p JSON.parse(salvo, symbolize_names: true)
10p JSON.parse(salvo).transform_keys(&:to_sym)1nil
27
3"{\"volume\":7,\"tema\":\"escuro\"}"
4{"volume"=>7, "tema"=>"escuro"}
5{:volume=>7, :tema=>"escuro"}
6{:volume=>7, :tema=>"escuro"}:volume e "volume" são chaves diferentes: o Ruby nunca transforma uma na outra. Isso pega todo mundo pelo menos uma vez, principalmente com dados vindos de JSON, que sempre voltam com chaves string.
Chaves símbolo são mais rápidas? Um pouco. Medimos:
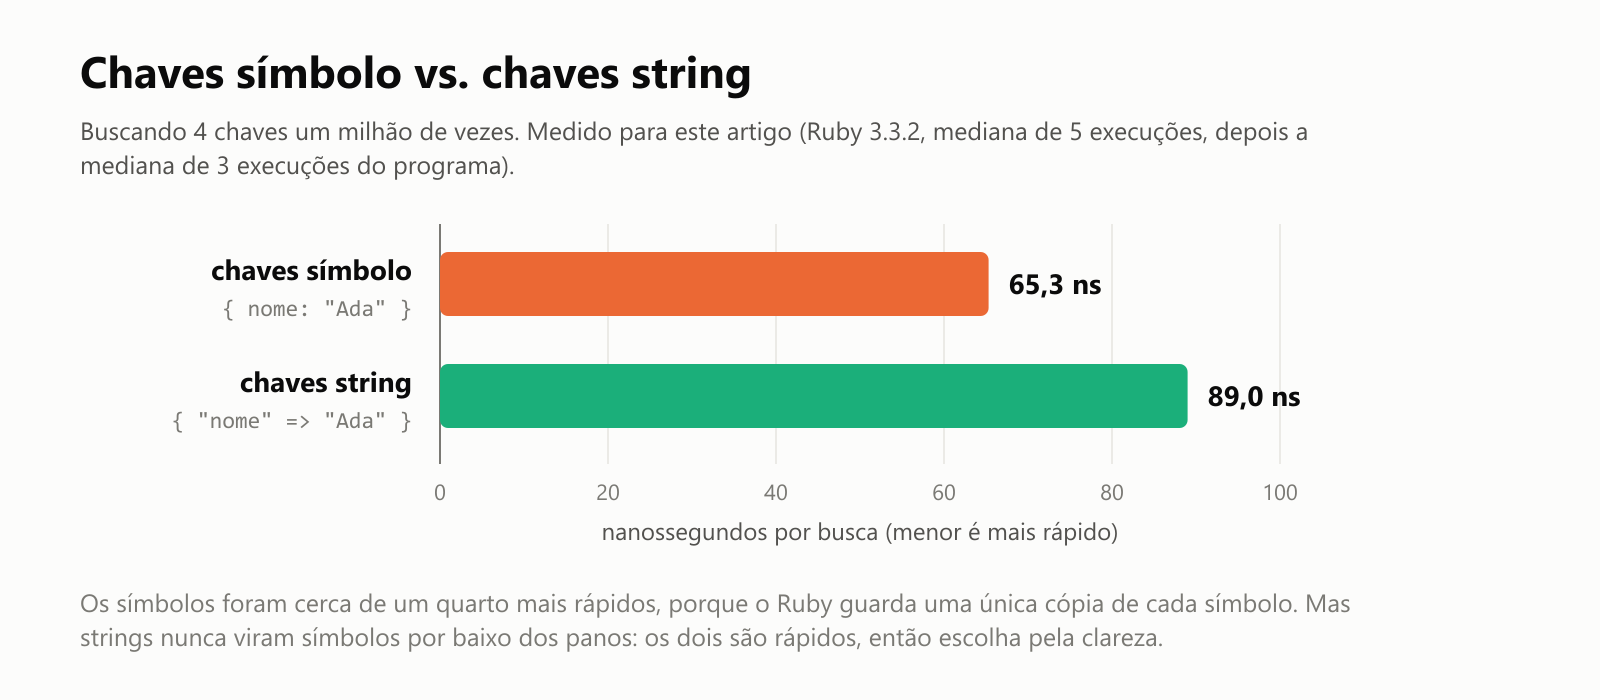
Os símbolos ganharam por cerca de um quarto, porque o Ruby guarda exatamente uma cópia de cada símbolo e consegue compará-los na hora. Mas estamos falando de 24 bilionésimos de segundo por busca. Escolha o estilo que deixa o seu código mais claro e consistente.
Dados aninhados e dig
Dados do mundo real, como o JSON de uma API da web, costumam ser hashes dentro de arrays dentro de hashes:

1usuario = {
2  nome: "Ada",
3  endereco: { cidade: "Londres", pais: "Reino Unido" },
4  pets: [{ nome: "Byron", tipo: "gato" }],
5}
6
7p usuario[:endereco][:cidade]
8p usuario.dig(:pets, 0, :nome)
9p usuario.dig(:emprego, :cargo)
10begin
11  usuario[:emprego][:cargo]
12rescue NoMethodError => erro
13  puts "Sem o dig: #{erro.message}"
14end1"Londres"
2"Byron"
3nil
4Sem o dig: undefined method `[]' for nilusuario[:emprego] é nil, e pedir [:cargo] ao nil quebra o programa. O dig para no primeiro passo que falta e dá nil.
Argumentos nomeados: opções com nome
Código Ruby mais antigo costumava passar um hash como último argumento de um método para dar opções com nome. O Ruby moderno tem uma ferramenta melhor embutida, os argumentos nomeados (keyword arguments), com valores padrão e verificação de erros:
1def saudacao(nome, dia: "hoje", tarefa: "descansar")
2  puts "Olá, #{nome}! #{dia.capitalize} você tem que #{tarefa}."
3end
4
5saudacao("Tiago")
6saudacao("Tiago", dia: "segunda", tarefa: "lavar o carro")
7saudacao("Tiago", tarefa: "lavar a roupa")
Olá, Tiago! Hoje você tem que descansar.
Olá, Tiago! Segunda você tem que lavar o carro.
Olá, Tiago! Hoje você tem que lavar a roupa.Na chamada, eles parecem um hash, mas o Ruby confere tudo para você. Uma opção digitada errado é um erro, não um nil silencioso:
1def saudacao(nome, dia: "hoje", tarefa: "descansar")
2  puts "Olá, #{nome}! #{dia.capitalize} você tem que #{tarefa}."
3end
4
5saudacao("Tiago", clima: "ensolarado")
erro_nomeado.rb:1:in `saudacao': unknown keyword: :clima (ArgumentError)
from erro_nomeado.rb:5:in `<main>'("Palavra-chave desconhecida: :clima.")
Quão rápido é um hash?
Um hash não procura as chaves uma por uma. Ele transforma cada chave num número (o código hash, que dá nome à estrutura) e usa esse número para pular direto para a casa certa. Medimos as buscas conforme o hash crescia:
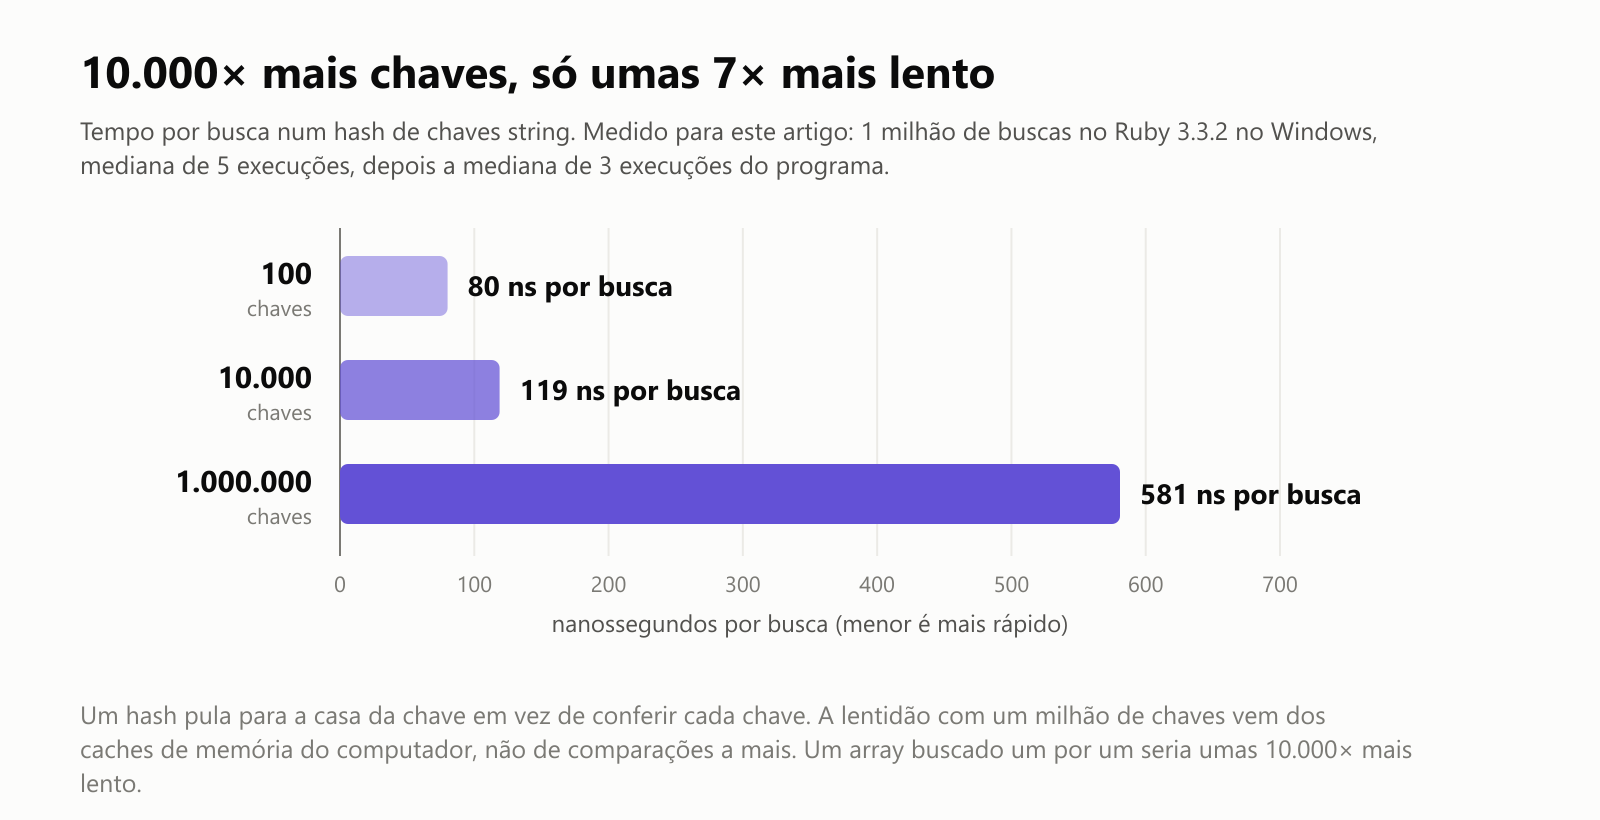
Ir de 100 chaves para um milhão de chaves deixou cada busca só umas 7 vezes mais lenta, e essa lentidão vem dos caches de memória do computador (um hash grande não cabe mais na memória mais rápida), não de trabalho a mais. Buscar um por um num array de um milhão de itens poderia exigir um milhão de comparações por busca.
Convertendo entre hashes e arrays
1capitais = { "França" => "Paris", "Japão" => "Tóquio", "Brasil" => "Brasília" }
2p capitais.invert
3p capitais.key("Tóquio")
4p capitais.to_a
5p [["a", 1], ["b", 2]].to_h
6p %w[x y z].zip([1, 2, 3]).to_h1{"Paris"=>"França", "Tóquio"=>"Japão", "Brasília"=>"Brasil"}
2"Japão"
3[["França", "Paris"], ["Japão", "Tóquio"], ["Brasil", "Brasília"]]
4{"a"=>1, "b"=>2}
5{"x"=>1, "y"=>2, "z"=>3}O invert troca chaves por valores, o key acha a chave de um valor e o to_h transforma uma lista de pares de volta num hash.
Um mapa dos métodos de hash do dia a dia

Hora de praticar
Tente fazer estes antes de espiar as respostas.
Exercício 1: Adivinhe a saída (aquecimento). O que as três linhas com p imprimem?
1letras = Hash.new(0)
2"banana".each_char { |letra| letras[letra] += 1 }
3p letras["a"]
4p letras["z"]
5p letras.size
Exercício 2: Estoque. Uma loja tem { caderno: 10, caneta: 25, mochila: 2 }. Processe os pedidos [[:caneta, 5], [:mochila, 3], [:caderno, 4], [:borracha, 1]]: venda quando houver estoque suficiente e, senão, imprima um aviso. Mostre o estoque final.
Exercício 3: Agenda ao contrário. Dada uma agenda de nomes para telefones, descubra de quem é um número e imprima ninguém para um número desconhecido.
Exercício 4: Agrupar pela primeira letra. Agrupe %w[abacate amora banana bergamota caju acerola] pela primeira letra e imprima cada grupo, em ordem.
Exercício 5: Somar pontos. Junte os pontos de segunda e de terça em totais, somando quando um jogador aparecer nos dois dias.
Exercício 6: Tradutor de bolso (desafio). Monte um hash de dicionário português-inglês e traduza uma frase palavra por palavra. Palavras que não estiverem no dicionário devem aparecer entre [colchetes].
Quiz rápido
- Qual é a diferença entre
tarefas[:sexta]etarefas.fetch(:sexta)quando a chave não existe? { nome: "Ada" }e{ "nome" => "Ada" }são o mesmo hash?- O que há de errado com
Hash.new([])para agrupar? - O que
usuario.dig(:endereco, :cidade)faz queusuario[:endereco][:cidade]não faz? - Por que buscar uma chave num hash é rápido, mesmo com um milhão de chaves?
Respostas
Exercício 1: "banana" tem três letras a, uma chave que não existe vale o padrão 0, e são 3 letras diferentes (b, a, n):
1letras = Hash.new(0)
2"banana".each_char { |letra| letras[letra] += 1 }
3p letras["a"]
4p letras["z"]
5p letras.size
3
0
3Exercício 2: O fetch com reserva 0 cuida do item que nem está no estoque:
1estoque = { caderno: 10, caneta: 25, mochila: 2 }
2pedidos = [[:caneta, 5], [:mochila, 3], [:caderno, 4], [:borracha, 1]]
3
4pedidos.each do |item, quantidade|
5  disponivel = estoque.fetch(item, 0)
6  if quantidade <= disponivel
7    estoque[item] = disponivel - quantidade
8    puts "Vendi #{quantidade} #{item}"
9  else
10    puts "Não dá para vender #{quantidade} #{item}: só restam #{disponivel}"
11  end
12end
13p estoque1Vendi 5 caneta
2Não dá para vender 3 mochila: só restam 2
3Vendi 4 caderno
4Não dá para vender 1 borracha: só restam 0
5{:caderno=>6, :caneta=>20, :mochila=>2}Exercício 3: O invert monta o hash de número para nome de uma vez:
1agenda = { "Ana" => "555-0101", "Bruno" => "555-0199", "Carla" => "555-0142" }
2por_numero = agenda.invert
3
4puts "O 555-0199 é de #{por_numero['555-0199']}"
5puts "O 555-0000 é de #{por_numero.fetch('555-0000', 'ninguém')}"
O 555-0199 é de Bruno
O 555-0000 é de ninguémExercício 4: O group_by devolve um hash de letra para palavras; ordenar o hash ordena pelas chaves:
1palavras = %w[abacate amora banana bergamota caju acerola]
2por_letra = palavras.group_by { |palavra| palavra[0] }
3por_letra.sort.each do |letra, grupo|
4  puts "#{letra}: #{grupo.sort.join(', ')}"
5end
a: abacate, acerola, amora
b: banana, bergamota
c: cajuExercício 5: O merge com bloco decide o que fazer quando os dois hashes têm a mesma chave:
1segunda = { "Ana" => 30, "Bruno" => 25 }
2terca = { "Bruno" => 40, "Carla" => 35 }
3
4total = segunda.merge(terca) { |nome, primeira_nota, segunda_nota| primeira_nota + segunda_nota }
5p total
{"Ana"=>30, "Bruno"=>65, "Carla"=>35}Exercício 6: O fetch com reserva deixa as palavras desconhecidas à vista:
1DICIONARIO = {
2  "o" => "the", "gato" => "cat", "come" => "eats", "peixe" => "fish",
3  "cão" => "dog", "gosta" => "likes", "de" => "of",
4}.freeze
5
6def traduz(frase)
7  frase.downcase.split.map { |palavra| DICIONARIO.fetch(palavra, "[#{palavra}]") }.join(" ")
8end
9
10puts traduz("O gato come peixe")
11puts traduz("O cão gosta de pizza")
the cat eats fish
the dog likes of [pizza]O "likes of" mostra por que tradução de verdade é bem mais difícil (ordem das palavras, expressões, conjugações), mas buscas num dicionário como esta são por onde ela começa.
Quiz: (1) O [] devolve nil; o fetch gera um KeyError (a não ser que você dê um valor reserva). (2) Não: um tem a chave símbolo :nome, o outro a chave string "nome", e o Ruby as trata como chaves diferentes. (3) Toda chave que falta divide um único array, então o << acrescenta os nomes nesse padrão compartilhado em vez de guardá-los no hash; use Hash.new { |hash, chave| hash[chave] = [] }. (4) Se :endereco não existir, o dig devolve nil em vez de quebrar com "undefined method [] for nil". (5) Um hash transforma a chave num número e pula direto para a casa dela em vez de conferir as chaves uma por uma; no nosso teste, um milhão de chaves deixou cada busca só umas 7 vezes mais lenta que 100 chaves.
Cola rápida
| Eu quero… | Escreva |
|---|---|
| Criar um hash | { nome: "Ada", nascimento: 1815 } ou { "nome" => "Ada" } |
| Ler um valor | h[:nome] (nil se não existir) |
| Ler, ou falhar em voz alta | h.fetch(:nome) |
| Ler com valor reserva | h.fetch(:nome, "desconhecido") |
| Ler dados aninhados | h.dig(:endereco, :cidade) |
| Acrescentar ou mudar | h[:cidade] = "Londres" |
| Tirar | h.delete(:cidade) |
| Juntar | h.merge(outro), ou merge(outro) { |chave, antigo, novo| … } |
| Verificar chave / valor | h.key?(:nome) / h.value?("Ada") |
| Percorrer | h.each { |chave, valor| … } |
| Filtrar / transformar | select, reject, transform_values, transform_keys |
| Contar coisas | Hash.new(0) e depois contagem[coisa] += 1, ou lista.tally |
| Agrupar coisas | Hash.new { |hash, chave| hash[chave] = [] }, ou lista.group_by { } |
| Opções com nome num método | def metodo(nome, cor: "vermelho") |
| De / para pares | pares.to_h / h.to_a |
| Chaves símbolo vindas de JSON | JSON.parse(texto, symbolize_names: true) |
Resumindo
Hashes são o jeito de os programas Ruby acharem coisas pelo nome:
- Pares chave-valor:
{ nome: "Ada" }para chaves símbolo,{ "nome" => "Ada" }para qualquer chave. - Leitura: o
[]dánilpara uma chave que não existe, ofetchgera um erro (ou usa o seu valor reserva), e odigpercorre dados aninhados com segurança. - Padrões: o
Hash.new(0)conta e oHash.new { |hash, chave| hash[chave] = [] }agrupa, mas oHash.new([])divide um único array entre todas as chaves. :nomee"nome"são chaves diferentes. Os símbolos foram cerca de um quarto mais rápidos no nosso teste, mas escolha pela clareza e pela consistência.- Argumentos nomeados dão opções com nome aos métodos, com valores padrão e verificação de erros de digitação.
- As buscas continuam rápidas: ir de 100 para um milhão de chaves deixou cada busca só umas 7 vezes mais lenta no nosso teste.
Para mais Ruby, leia O Que É a Linguagem de Programação Ruby?, Arrays em Ruby, Métodos de String em Ruby e Entrada e Saída de Arquivos em Ruby.
Leia a seguir
O Que É a Linguagem de Programação Rust? Um Guia Simples da Linguagem Rápida Que Não Deixa Você Travar
Um guia simples e sem jargões sobre o Rust, a linguagem tão rápida quanto o C que impede famílias inteiras de erros de memória antes de o programa rodar. Entenda a ideia de posse, por que gigantes da tecnologia o adotam e onde ele é usado.
 nbkhope
O Que É a Linguagem de Programação Go? Um Guia Simples da Linguagem da Nuvem
Um guia simples e sem jargões sobre o Go, a linguagem simples e rápida que o Google criou para a nuvem. Entenda o que são goroutines, por que um programa Go é um arquivo só e como o Go passou a mover o Docker, o Kubernetes e boa parte da internet.
nbkhope
O Que É a Linguagem de Programação Ruby? Um Guia Simples da Linguagem Feita para a Felicidade
Um guia simples e sem jargões sobre o Ruby, a linguagem de programação feita para deixar os programadores felizes. Entenda por que o código Ruby parece inglês, como o Ruby on Rails move sites como GitHub e Shopify, e onde o Ruby brilha.
nbkhope
Comentários
Seja gentil e específico. Comentários com links de contas novas aparecem depois da análise de um moderador.