
Por Dentro de uma Resposta da IA: O Que Faz a GPU NVIDIA
Acompanhe uma pergunta de IA dentro de uma GPU NVIDIA: processamento do pedido, geração token a token, memória e lotes. Veja um gráfico calculado sobre conversas longas.

Nesta página
Por Dentro de uma Resposta da IA: O Que Faz a GPU NVIDIA
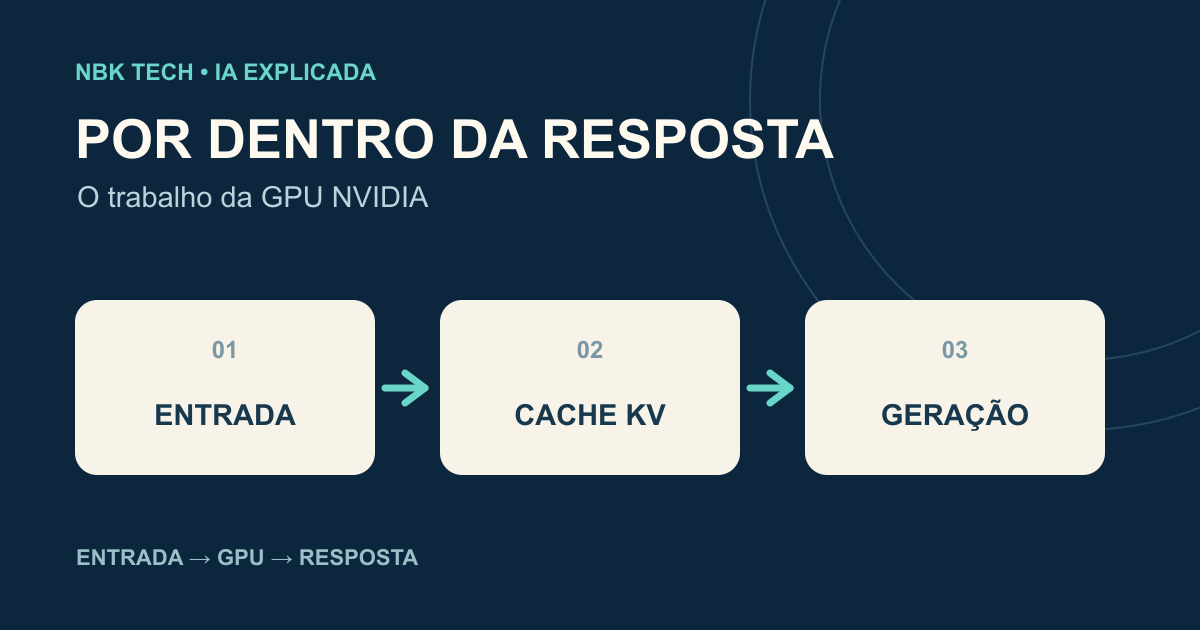
Você envia uma pergunta a um assistente de IA. Logo aparecem palavras na tela. O que aconteceu entre o botão Enviar e a primeira palavra? Se o serviço usa GPUs NVIDIA, a resposta envolve dois trabalhos bem diferentes, um atalho de memória e uma organização esperta das solicitações.
Este é um passeio pela inferência: executar um modelo já treinado para responder. Para conhecer a história da empresa, seus negócios e um teste real de CPU contra GPU, leia O Que É a NVIDIA?. Nem todo serviço de IA usa equipamentos NVIDIA; um serviço também pode distribuir o trabalho entre várias máquinas. O fluxo abaixo simplifica uma configuração comum de modelo de linguagem.
Dois trabalhos dentro de uma resposta
Imagine perguntar: “Explique as fases da Lua em três frases.” Primeiro o sistema transforma o texto em tokens, pedaços que o modelo processa. Depois executa duas etapas:
| Etapa | O que a GPU faz | O que você percebe |
|---|---|---|
| Prefill (processamento inicial) | Processa os tokens de entrada em conjunto e prepara informações para a geração | Uma pausa antes da primeira palavra |
| Decode (geração) | Produz um novo token, usa-o como contexto e repete | As palavras aparecem aos poucos |
Pense em um restaurante: o processamento inicial equivale a ler o pedido completo e preparar a cozinha. A geração monta a resposta aos poucos. A comparação tem limites: a GPU faz cálculos com matrizes, não procura uma frase pronta. A explicação técnica da NVIDIA descreve as duas fases e suas exigências diferentes.
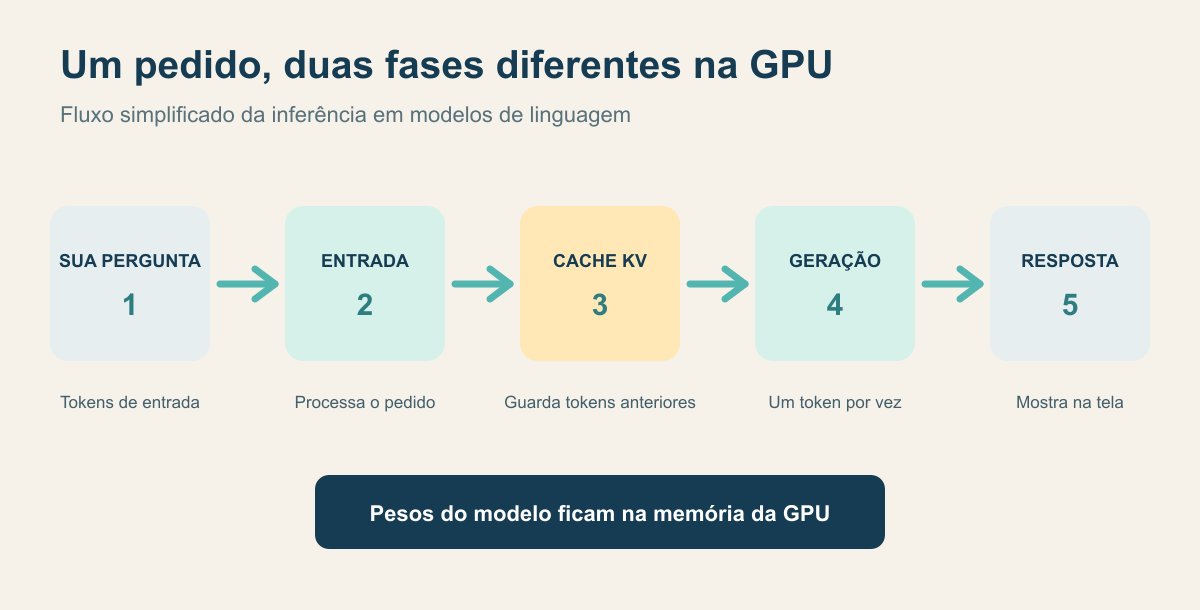
Os pesos do modelo são números aprendidos e carregados na memória da GPU. No processamento inicial, o modelo também prepara informações de chaves e valores usadas pela atenção. Para não recalculá-las para todos os tokens anteriores a cada passo, o servidor pode manter um cache KV. Cada token novo acrescenta dados a esse cache. Isso poupa trabalho repetido, mas ocupa memória. A documentação TensorRT da NVIDIA descreve a dimensão de tokens do cache.
Onde entra o equipamento da NVIDIA
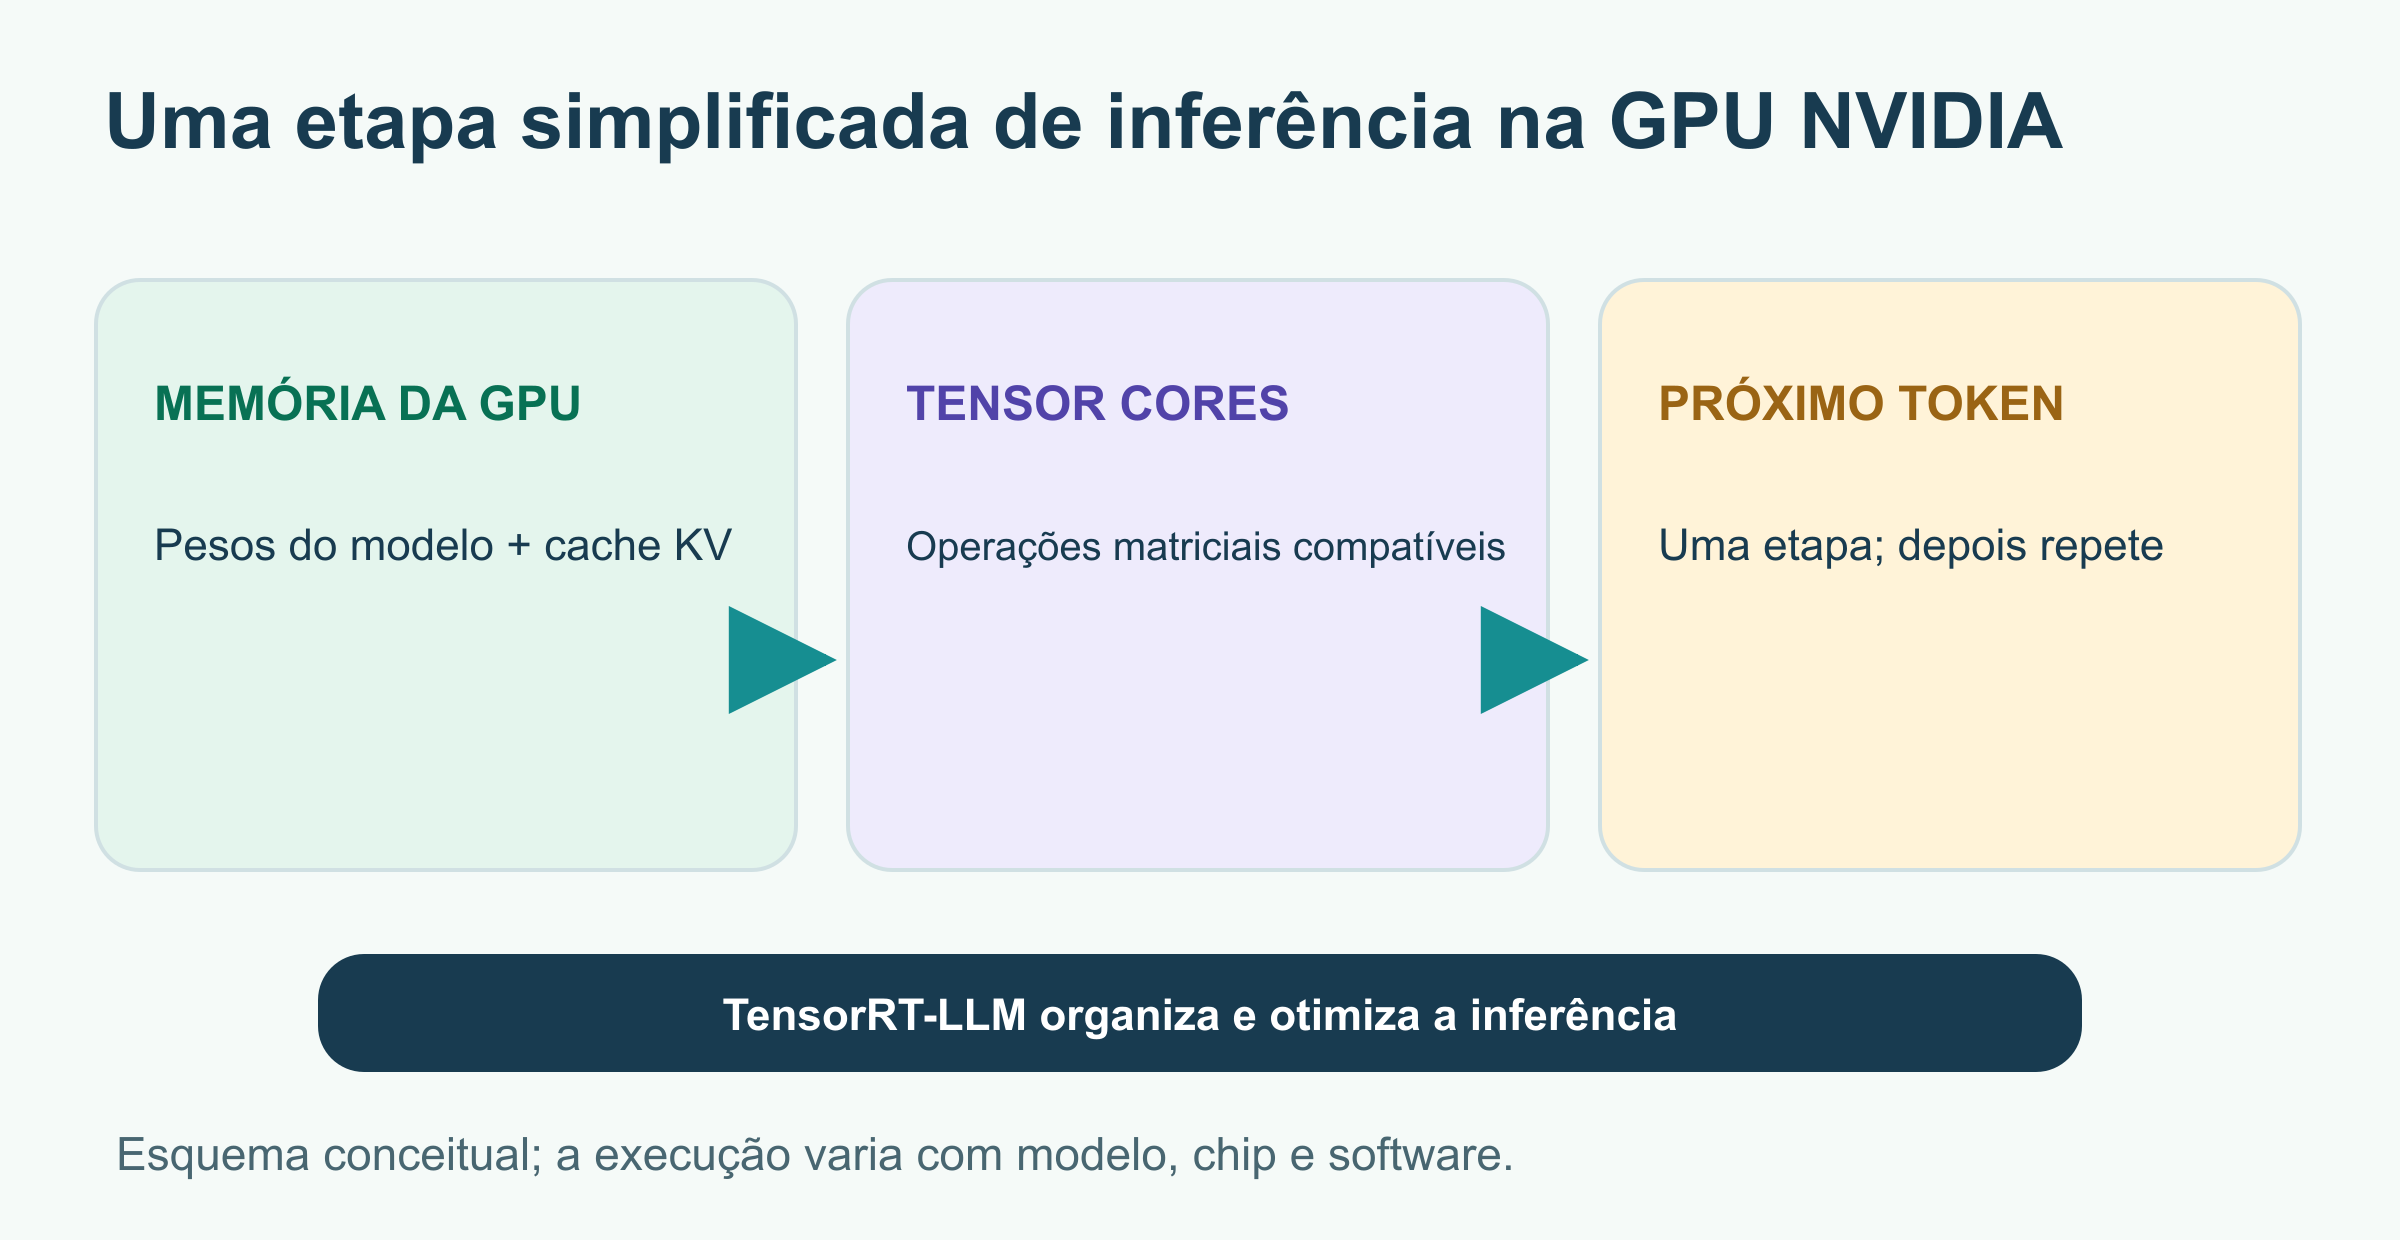
A GPU não guarda uma resposta pronta. A memória contém pesos e dados de trabalho, enquanto as unidades de cálculo executam as operações do modelo. Os Tensor Cores da NVIDIA são especializados em multiplicação e acumulação de matrizes; quais operações os usam depende do modelo, formato numérico, equipamento e software. A visão da arquitetura da NVIDIA descreve sua função. Programas como TensorRT-LLM organizam a inferência, mas o chip sozinho não decide como responder à pergunta.
Um gráfico que você pode calcular
Quanto espaço esse cache pode usar? Considere esta configuração ilustrativa, não uma medição de uma GPU NVIDIA específica nem de um serviço comercial:
32 camadas × 8 cabeças KV × 128 valores por cabeça
× 2 conjuntos (chaves e valores) × 2 bytes por valor
= 131.072 bytes por token = 128 KiB por token
A conta fica simples: quatro vezes mais tokens significam quatro vezes mais espaço para o cache KV de uma solicitação, mantendo o modelo e o formato numérico iguais.
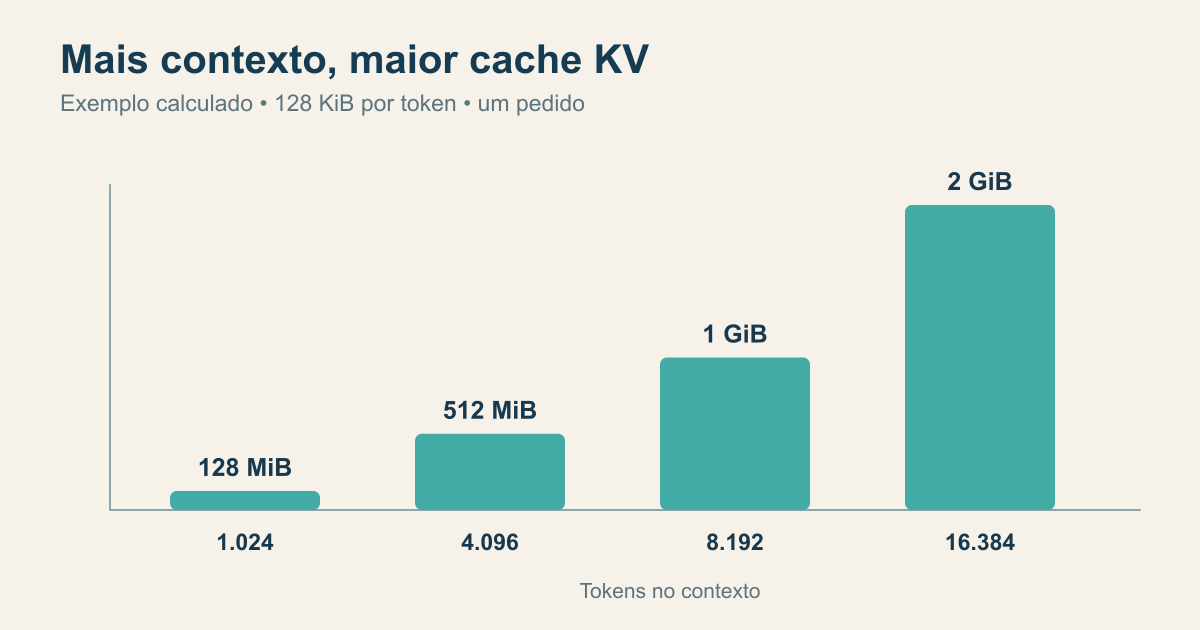
| Tokens no contexto | Cache KV calculado |
|---|---|
| 1.024 | 128 MiB |
| 4.096 | 512 MiB |
| 8.192 | 1 GiB |
| 16.384 | 2 GiB |
A conta não inclui pesos do modelo, memória temporária, várias solicitações simultâneas nem custos extras da implementação. Modelos reais variam em camadas, organização da atenção, precisão e otimizações. O importante é a tendência: em um projeto fixo, mais contexto ocupa mais memória. A visão técnica da NVIDIA também descreve como o cache cresce com o tamanho da sequência e com o número de solicitações processadas juntas.
Por que uma pergunta curta pode demorar
O tempo até o primeiro token visível e o ritmo dos tokens seguintes são medidas diferentes. Um documento longo aumenta o trabalho de processamento inicial; pedir um texto longo acrescenta passos de geração. A fila de outras pessoas pode afetar ambos. Um cronômetro sozinho não revela a velocidade da GPU sem saber o modelo, o tamanho da entrada e da saída, a carga do servidor e as condições da rede.
Há duas formas importantes de avaliar o serviço:
- Latência: quanto uma pessoa espera pelo primeiro token ou pela resposta completa.
- Vazão: quantos tokens ou pedidos o sistema atende para muitas pessoas em determinado período.
Agrupar pedidos em um lote pode aproveitar melhor a GPU, mas nem sempre reduz a espera individual. Sistemas como o TensorRT-LLM usam recursos de lotes dinâmicos para reunir solicitações ativas e abrir espaço quando uma termina. Outra técnica é a quantização, que guarda certos números em menos bits; ela pode reduzir a memória e acelerar operações, mas velocidade e qualidade precisam ser medidas para cada modelo e equipamento.
O que lembrar quando o texto surgir na tela
A primeira palavra e as seguintes vêm de fases diferentes. O cache KV evita repetir cálculos, enquanto contextos longos e muitos usuários disputam memória. A NVIDIA vende equipamentos e software para executar esse fluxo, mas a pergunta mais útil vai além da marca: qual tarefa está sendo atendida e o que limita o resultado—demora até o primeiro token, velocidade de geração ou capacidade total?
Continue com O Que É um LLM? e O Que É Aprendizado Profundo?.
Fontes e leitura adicional
Leia a seguir
Os 5 melhores agentes de IA para programar em 2026: qual combina com você?
Cinco agentes de IA para programar, cinco jeitos de trabalhar. Compare Claude Code, Codex, Cursor, GitHub Copilot e Google Antigravity com exemplos e um guia de escolha.
 nbkhope
Como Proteger Sua Privacidade ao Usar Ferramentas de IA
Proteja sua privacidade ao usar IA com um passo a passo para retirar dados pessoais, conferir controles da conta, cuidar de arquivos e revisar links compartilhados.
nbkhope
Como Conferir uma Resposta da IA Antes de Usá-la
Uma resposta da IA pode trazer uma data errada, uma informação inventada ou uma conta incorreta. Aprenda cinco passos para conferir o que importa antes de usar a resposta.
nbkhope
Comentários
Seja gentil e específico. Comentários com links de contas novas aparecem depois da análise de um moderador.