O Que É Aprendizado Profundo? Como Computadores Aprendem a Ver, Ouvir e Falar
Uma introdução simples e sem jargões ao aprendizado profundo (deep learning), a tecnologia por trás do reconhecimento facial, dos assistentes de voz e dos chatbots. Entenda as redes neurais e veja uma rede de verdade aprender.

Nesta página
Como o seu celular sabe que uma foto tem o seu cachorro? Como um assistente de voz transforma o seu "põe um timer de dez minutos", meio resmungado, num timer de verdade? Como um chatbot escreve um poema sobre o seu gato?
A resposta para as três perguntas é a mesma: aprendizado profundo (em inglês, deep learning). É a tecnologia por trás de quase todos os grandes saltos da IA nos últimos quinze anos, de reconhecer rostos a traduzir idiomas e conversar com você em português claro.
O nome assusta, mas a ideia central é surpreendentemente simples. Este artigo explica tudo em linguagem do dia a dia, passo a passo, sem nenhuma matemática além de somar alguns números. Você ainda vai ver um sistema de aprendizado profundo de verdade (bem pequeno) aprendendo.
Onde o aprendizado profundo se encaixa
A inteligência artificial é o guarda-chuva maior: computadores fazendo tarefas que costumam exigir inteligência humana. Dentro dela está o aprendizado de máquina (explicado aqui), em que computadores aprendem com exemplos em vez de seguir regras escritas por pessoas. E dentro do aprendizado de máquina está o aprendizado profundo: aprender com grandes redes neurais.
E o que é uma rede neural? Para entender, vamos começar pela peça menor.
A peça básica: um neurônio artificial
O seu cérebro tem cerca de 86 bilhões de células nervosas, os neurônios, ligadas umas às outras. O aprendizado profundo se inspira nisso de forma bem livre. Um neurônio artificial não é uma célula de verdade, só um pedacinho de matemática que toma uma pequena decisão.
Veja como funciona, com uma decisão que você poderia tomar numa manhã de verão:
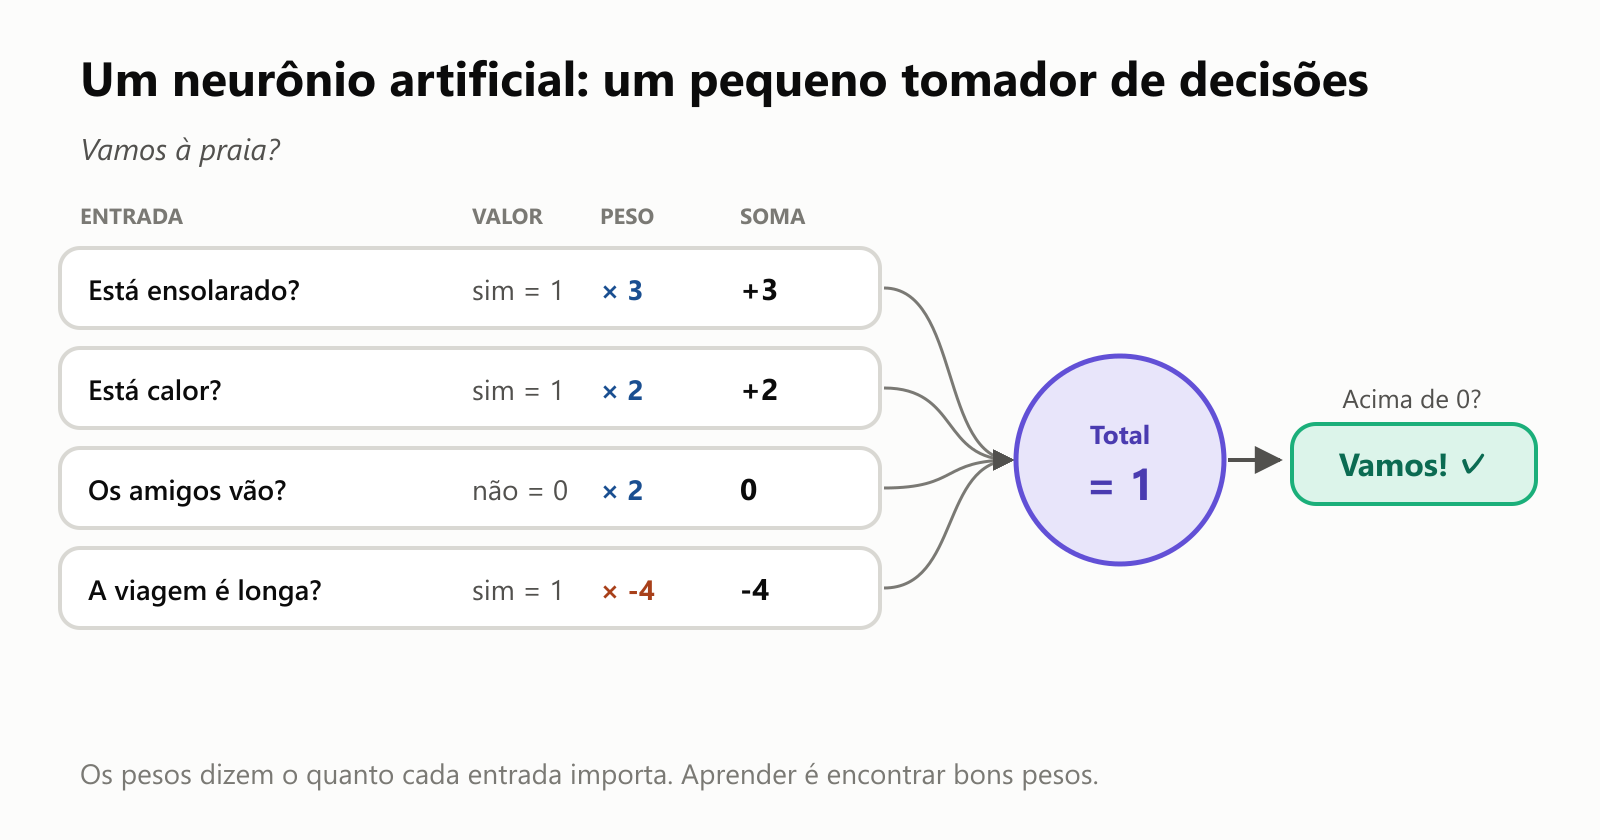
- O neurônio recebe algumas entradas: está ensolarado, está calor, os amigos vão, a viagem é longa?
- Cada entrada tem um peso, um número que diz o quanto ela importa. O sol importa muito (+3). Uma viagem longa conta contra (−4).
- O neurônio multiplica cada entrada pelo seu peso e soma tudo.
- Se o total for alto o bastante, o neurônio "dispara": vamos à praia!
Só isso. Um neurônio é só uma votação com pesos. A mágica está nos pesos: mude os pesos, e o mesmo neurônio toma decisões diferentes. Para uma rede neural, aprender é encontrar bons pesos.
Muitos neurônios, muitas camadas
Um neurônio sozinho só toma decisões simples. Mas ligue milhares ou milhões deles, organizados em camadas, e você tem uma rede neural:
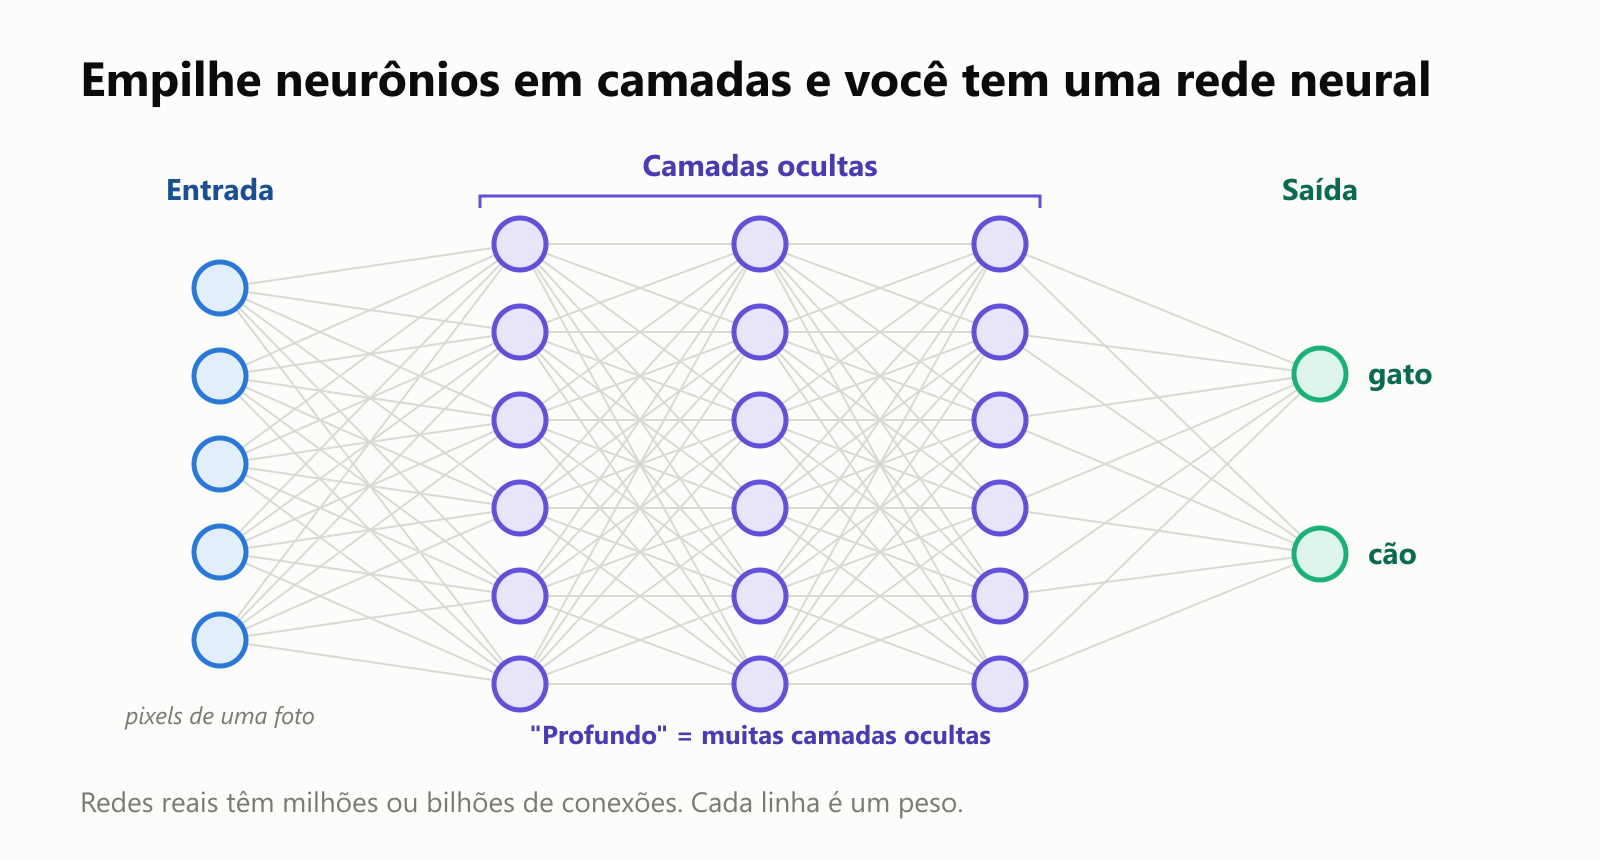
- A camada de entrada recebe a informação bruta, como a cor de cada pontinho (pixel) de uma foto.
- As camadas ocultas, no meio, passam os sinais adiante, e cada neurônio combina as saídas da camada anterior.
- A camada de saída dá a resposta, como a chance de a foto ser de um gato ou de um cão.
Cada linha da imagem é um peso. Redes reais têm muitos: um modelo de chatbot famoso de 2020, o GPT-3, tinha 175 bilhões.
E é daí que vem o nome: uma rede com muitas camadas ocultas é chamada de profunda. É só isso que "profundo" quer dizer em aprendizado profundo. Não são pensamentos profundos, são pilhas profundas.
Por que as camadas são tão poderosas
Algo incrível acontece quando você empilha camadas. Cada camada aprende a perceber algo um pouco mais complexo do que a anterior. Em redes que reconhecem fotos, pesquisadores olharam por dentro e encontraram um padrão assim:
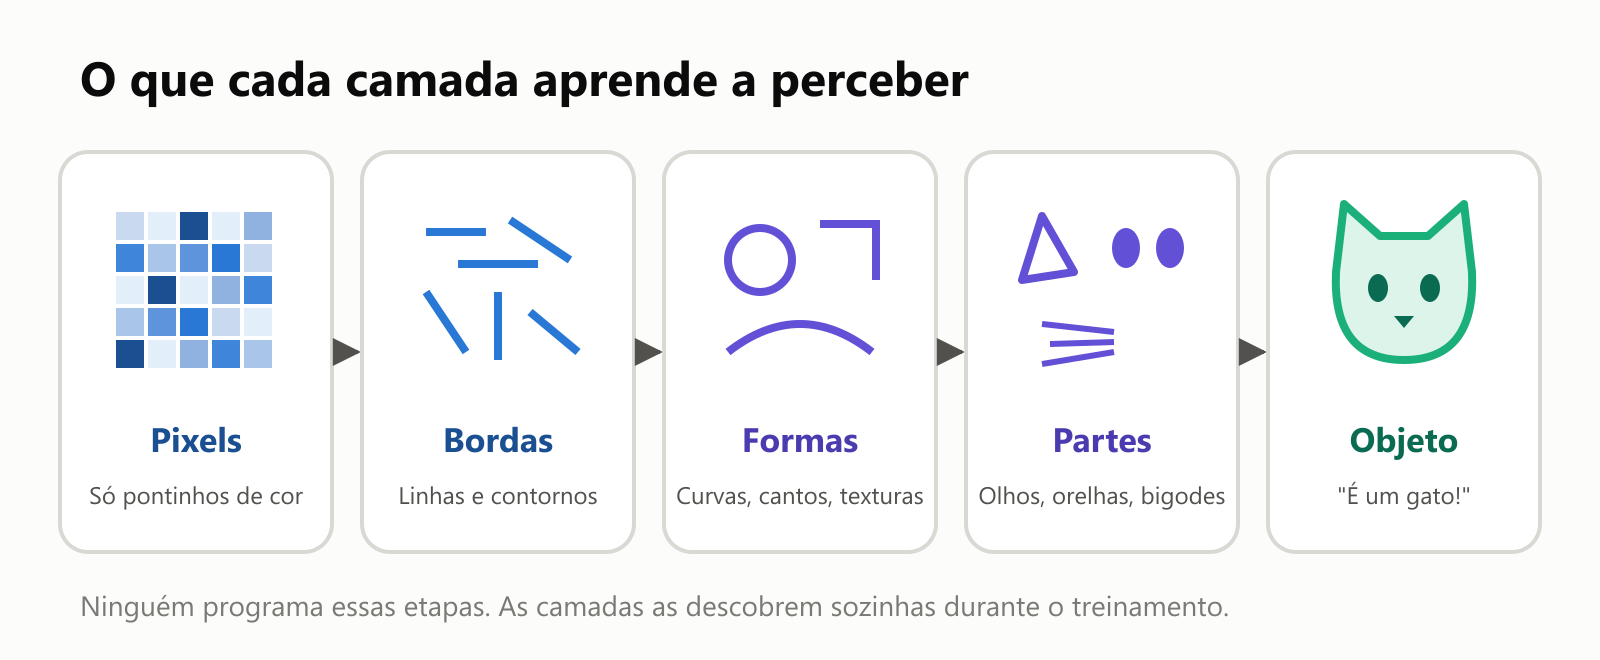
As primeiras camadas percebem bordas simples. As seguintes combinam bordas em formas e texturas. Camadas mais profundas juntam formas em partes, como olhos e orelhas. As últimas camadas montam as partes num objeto inteiro: um gato!
O mais incrível: ninguém programa essas etapas. Ninguém diz à rede "procure orelhas". Ela descobre sozinha que orelhas são boas pistas, só de ser treinada com muitas fotos identificadas.
Como uma rede aprende
Uma rede novinha tem pesos aleatórios, então as respostas dela são puro chute. Treiná-la é um ciclo:
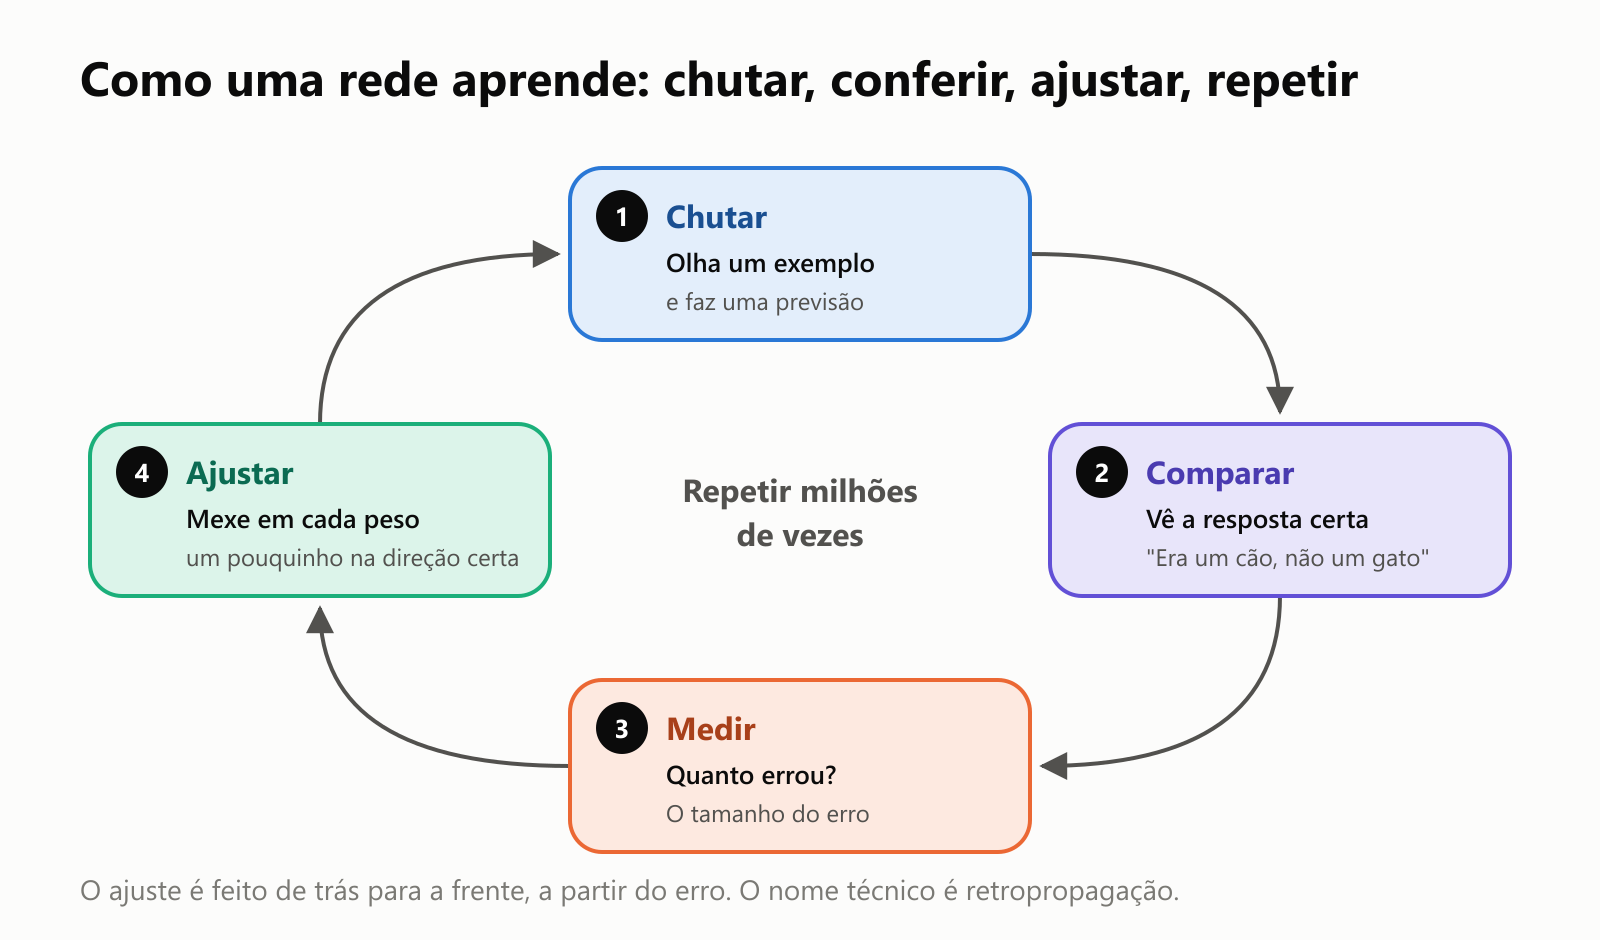
- Chutar. Mostre um exemplo à rede, como uma foto, e deixe ela fazer uma previsão.
- Comparar. Confira a previsão com a resposta certa.
- Medir. Calcule o quanto ela errou. Isso se chama erro (ou "perda").
- Ajustar. Mexa em cada peso um pouquinho, na direção que teria deixado o erro menor.
Depois, de novo. E de novo. Milhões de vezes, com milhões de exemplos.
A parte esperta é o passo 4. Com milhões de pesos, como saber para que lado girar cada um? Um método chamado retropropagação (backpropagation) trabalha de trás para a frente a partir do erro, passando por todas as camadas, e descobre o quanto cada peso teve culpa. Pense numa mesa de som gigante, com milhões de botões, e num ajudante que diz exatamente para que lado girar cada botão para a música ficar um pouco melhor.
Veja uma rede de verdade aprender
Falar é fácil, então aqui vai uma de verdade. Treinamos uma rede neural minúscula (uma pequena camada oculta com 8 neurônios) numa tarefa simples: olhar a posição de um ponto e decidir se ele está dentro do círculo (azul) ou fora (laranja). O sombreado mostra o palpite da rede para cada lugar.
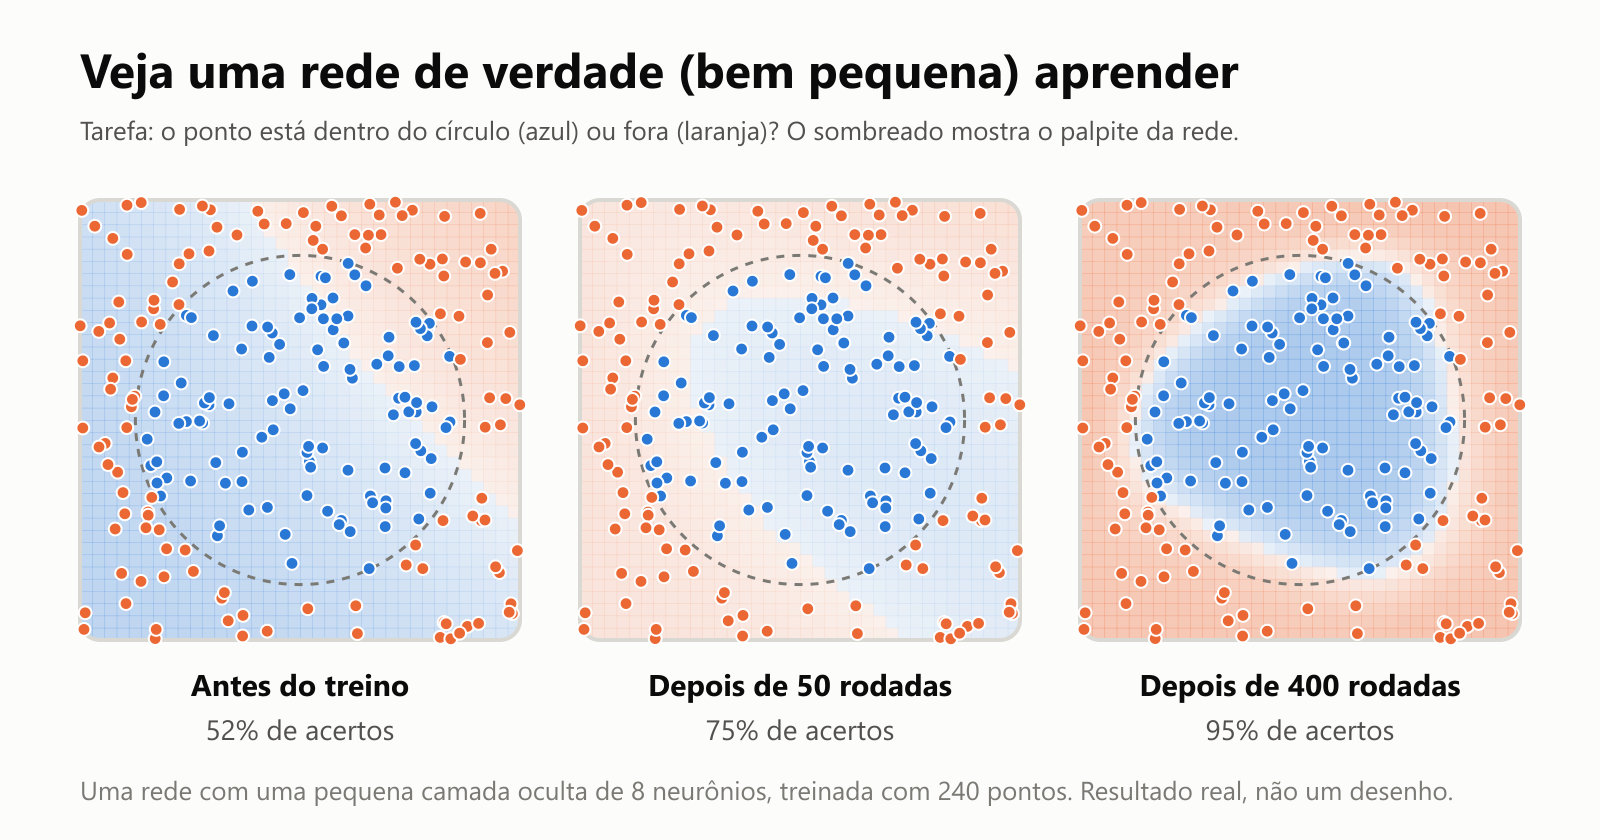
Antes do treino, os palpites da rede são aleatórios, e ela acerta mais ou menos metade, nada melhor que cara ou coroa. Depois de 50 rodadas de chutar, comparar e ajustar, aparece uma forma aproximada. Depois de 400 rodadas, ela descobriu o círculo sozinha e acerta 95%. Ninguém disse a palavra "círculo" para ela. Ela achou o padrão nos exemplos.
Veja o progresso dela, rodada a rodada:
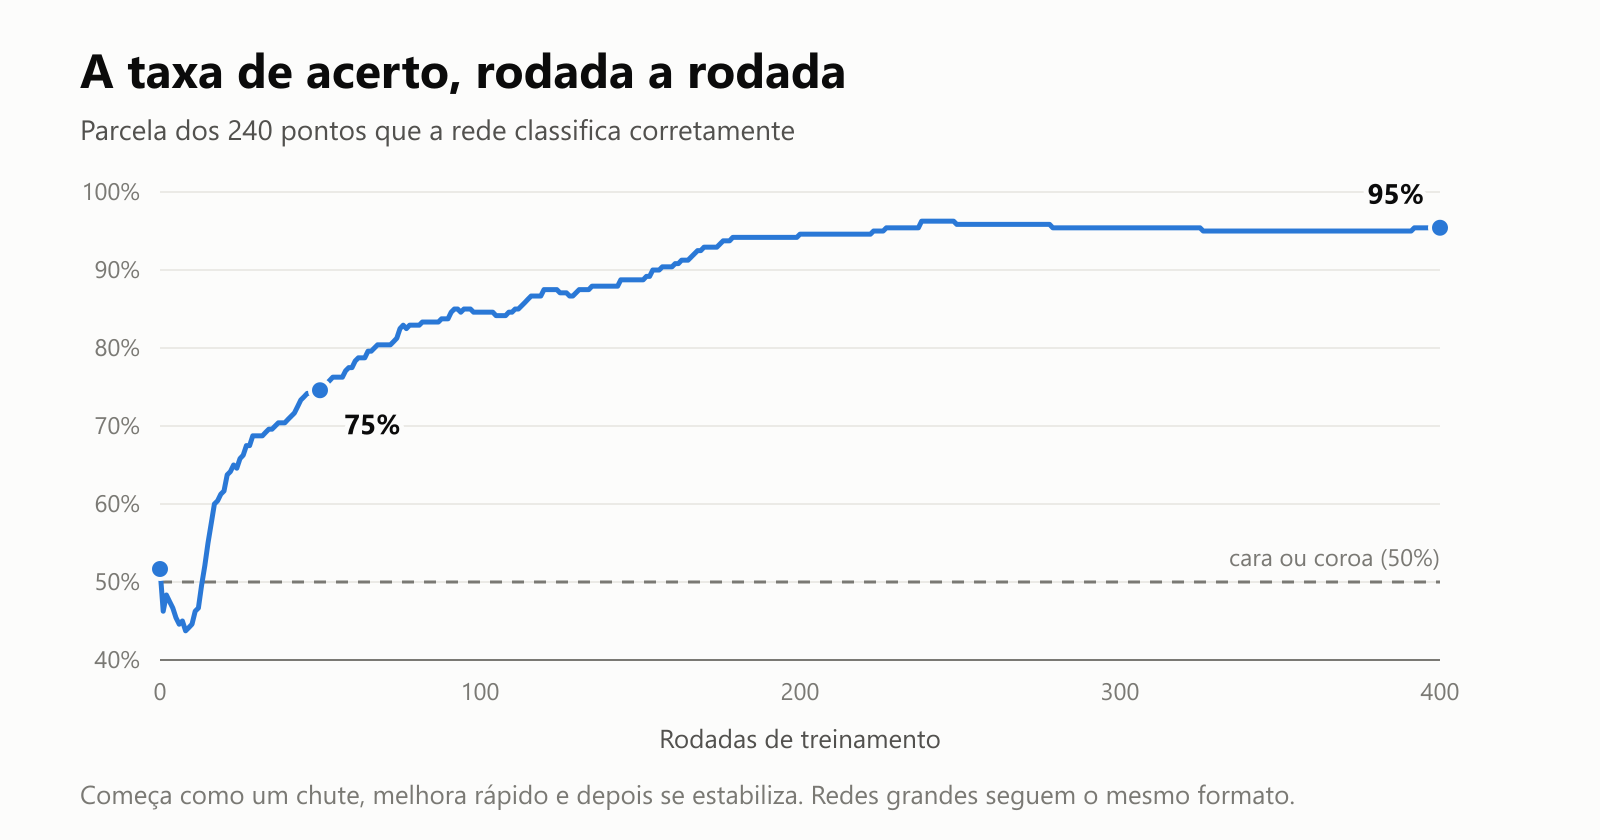
Esse formato, começo lento, melhora rápida e depois estabilização, aparece também em sistemas de IA gigantes. Eles só usam bilhões de pesos e exemplos, em vez de 8 neurônios e 240 pontos.
Por que o aprendizado profundo decolou quando decolou
Redes neurais não são novidade. O primeiro neurônio artificial capaz de aprender, o perceptron, foi criado por Frank Rosenblatt em 1958. Durante décadas, porém, as redes neurais foram mais uma curiosidade. Três coisas mudaram por volta de 2010:
- Dados. A internet criou coleções enormes de fotos, textos e áudios para aprender.
- Velocidade. Os chips gráficos (GPUs), feitos para videogames, se mostraram perfeitos para a quantidade enorme de cálculos simples que as redes neurais exigem.
- Técnicas melhores. Pesquisadores encontraram jeitos de treinar redes muito mais profundas sem que elas empacassem.
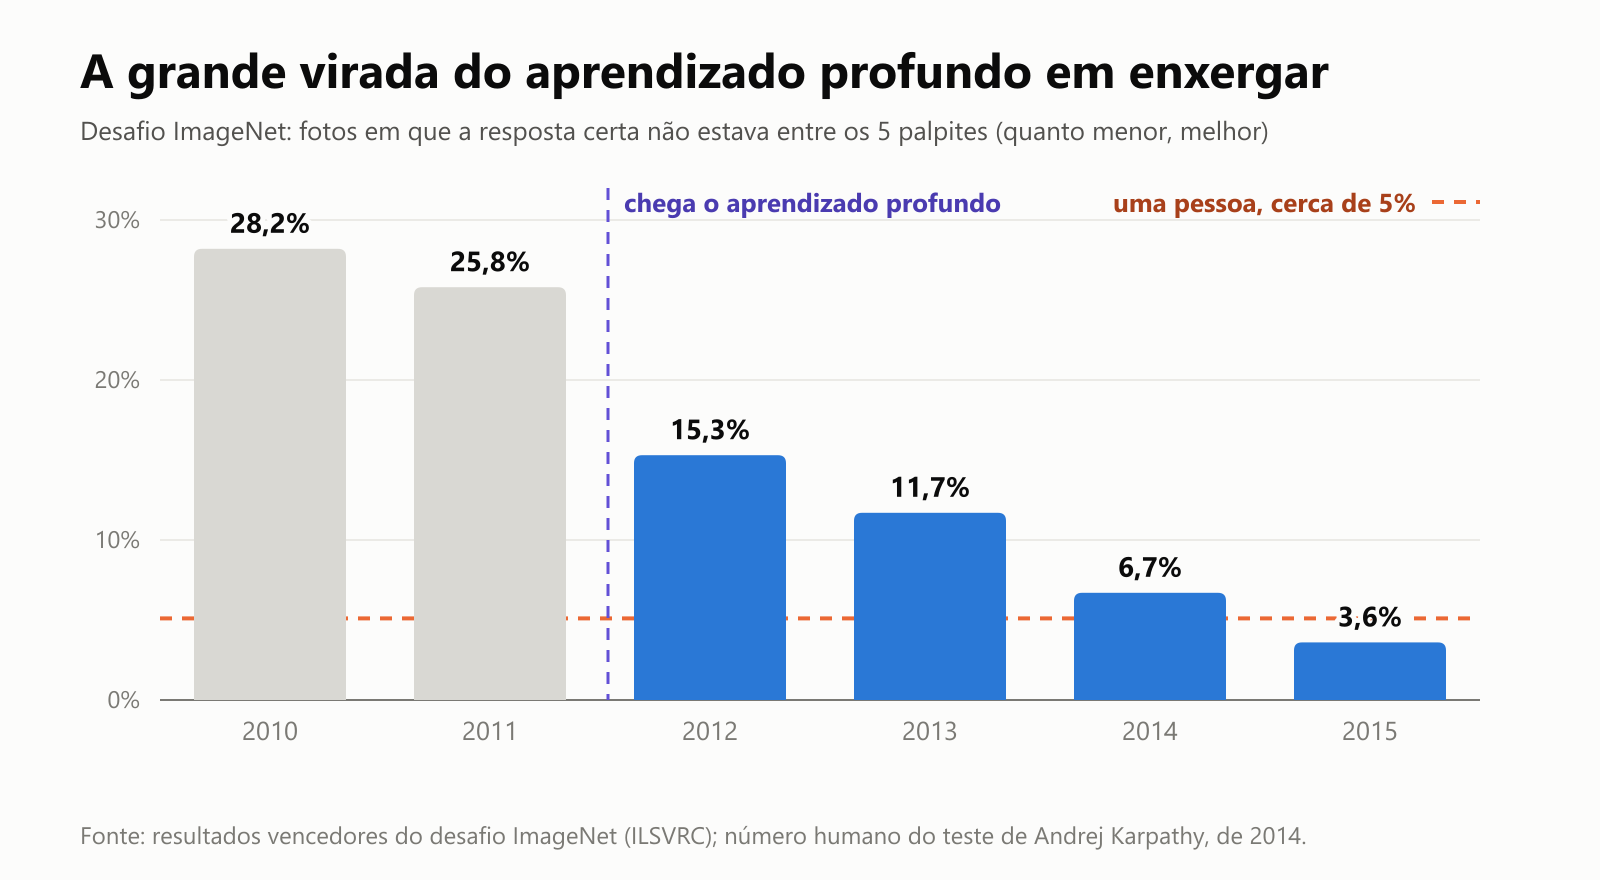
A virada veio em 2012, no desafio ImageNet, uma competição anual para reconhecer objetos em mais de um milhão de fotos. Uma rede profunda chamada AlexNet errou muito menos do que tudo o que existia antes. Em três anos, as redes profundas passaram a pontuação de uma pessoa:
Os pioneiros do aprendizado profundo Geoffrey Hinton, Yann LeCun e Yoshua Bengio receberam o Prêmio Turing de 2018, muitas vezes chamado de Nobel da computação, e Hinton dividiu o Prêmio Nobel de Física de 2024, de verdade, com John Hopfield, pelo trabalho pioneiro com redes neurais.
Onde você encontra aprendizado profundo todo dia
Hoje, o aprendizado profundo move boa parte da tecnologia à sua volta:
- Fotos: desbloqueio facial, buscar "praia" na galeria, desfocar o fundo em chamadas de vídeo.
- Voz: assistentes de voz, legendas automáticas, ditado.
- Idiomas: aplicativos de tradução e chatbots de IA. Os chatbots são feitos com um tipo de rede profunda chamado transformer, apresentado por pesquisadores do Google em 2017. (Saiba mais em O Que É um LLM?)
- Recomendações: quais séries, músicas e posts aparecem para você em seguida.
- Saúde: ajudar médicos a encontrar sinais de doenças em raios-X, tomografias e exames de olhos.
- Ciência: prever o formato 3D de proteínas, o que ajuda na pesquisa de remédios.
- Ferramentas criativas: gerar imagens, músicas e vídeos a partir de uma descrição em texto.
Os limites do aprendizado profundo
O aprendizado profundo é poderoso, mas tem fraquezas reais que vale conhecer:
| Ponto forte | Ponto fraco |
|---|---|
| Acha padrões para os quais ninguém conseguiria escrever regras | Precisa de quantidades enormes de exemplos |
| Melhora com mais dados e mais poder de computação | Treinar modelos grandes gasta muita energia e dinheiro |
| Lida com dados bagunçados do mundo real, como fotos e fala | É difícil explicar por que deu uma certa resposta |
| Pode ser reaproveitado e adaptado para novas tarefas | Pode ser enganado de jeitos que nunca enganariam uma pessoa |
| Absorve preconceitos escondidos nos exemplos de treino |
Essa história de ser enganado é real e um pouco assustadora. Num experimento famoso de 2014, pesquisadores acrescentaram um padrão de ruído cuidadosamente calculado à foto de um panda. Para uma pessoa, a imagem continuava idêntica. A rede, que antes dizia corretamente "panda", passou a dizer "gibão" com mais de 99% de certeza. Redes profundas reconhecem padrões de um jeito muito diferente do nosso.
Um pequeno glossário
- Aprendizado profundo (deep learning): aprendizado de máquina com redes neurais de muitas camadas.
- Neurônio artificial: uma pequena unidade que multiplica as entradas por pesos, soma tudo e passa um sinal adiante.
- Peso: um número que diz o quanto uma entrada importa. Aprender é ajustar os pesos.
- Rede neural: muitos neurônios artificiais ligados em camadas.
- Camada: um grupo de neurônios na mesma etapa. Há camadas de entrada, ocultas e de saída.
- Camada oculta: qualquer camada entre a entrada e a saída.
- Treinamento: ensinar uma rede mostrando exemplos e ajustando os pesos.
- Erro (ou perda): uma medida de quanto o palpite da rede errou.
- Retropropagação: o método que trabalha de trás para a frente a partir do erro para descobrir como ajustar cada peso.
- GPU: um chip gráfico, criado para videogames, muito bom nos cálculos de que o aprendizado profundo precisa.
- Transformer: um tipo de rede profunda, apresentado em 2017, por trás dos chatbots de IA atuais.
Concluindo
O aprendizado profundo parece complicado, mas é feito de uma peça bem simples: um neurônio que soma entradas com pesos. Empilhe milhões deles em muitas camadas, mostre milhões de exemplos e vá ajustando os pesos para os erros diminuírem. Dessa receita simples surgem sistemas capazes de reconhecer rostos, entender a fala, traduzir idiomas e conversar.
Não é mágica, e não é um cérebro. É encontrar padrões numa escala gigantesca. Da próxima vez que o seu celular achar todas as fotos do seu cachorro em um segundo, você vai saber que existe uma pilha profunda de camadas por trás disso, cada uma percebendo algo um pouco mais complexo que a anterior.
Read next
O Que É Aprendizado por Reforço? Como a IA Aprende com Tentativa, Erro e Recompensa
Uma introdução simples e sem jargões ao aprendizado por reforço, o jeito como a IA aprende com tentativa, erro e recompensa, como um cachorro aprendendo com petiscos. Veja um robô aprender um labirinto e como isso molda os chatbots.
 nbkhope
O Que É Engenharia de Grafos? Como a IA Trabalha em Equipe para Fazer Coisas de Verdade
Um guia simples e sem jargões sobre engenharia de grafos, a ideia de 2026 de montar a IA como um mapa de etapas conectadas. Veja como os agentes de IA funcionam, por que pequenos erros se acumulam e como revisões e trabalho em equipe resolvem isso.
nbkhope
O Que É Engenharia de Loops? Como Agentes de IA Trabalham Até Terminar o Serviço
Um guia simples e sem jargões sobre engenharia de loops, a ideia de 2026 de projetar o ciclo em que um agente de IA trabalha até terminar o serviço, com objetivos claros, feedback real, regras de parada e a hora de chamar uma pessoa.
nbkhope
Comentários
Be kind and specific. Comments with links from new accounts appear after a moderator reviews them.