O Que É Aprendizado de Máquina? Como Computadores Aprendem com Exemplos
Uma introdução simples e sem jargões ao aprendizado de máquina, o jeito como computadores aprendem com exemplos em vez de seguir regras. Veja os três tipos principais, como um modelo aprende, por que ele pode decorar e como avaliá-lo.

Nesta página
Como o seu banco percebe que um pagamento pode ser fraude antes de você? Como um aplicativo de música adivinha qual canção você vai querer ouvir em seguida? Como um site de imóveis estima quanto vale um apartamento?
Ninguém sentou e escreveu regras para cada pagamento, música ou imóvel possível. Em vez disso, esses computadores aprenderam com exemplos. Isso é aprendizado de máquina (em inglês, machine learning), e é o motor por trás da maior parte da tecnologia "inteligente" que você usa todo dia.
Este artigo explica o aprendizado de máquina em linguagem simples, com imagens e exemplos fáceis. Não precisa saber matemática nem programação, só ter curiosidade.
A grande ideia: aprender com exemplos
Um software tradicional segue instruções escritas por uma pessoa: "Se acontecer isto, faça aquilo." Isso funciona bem quando as regras são claras, como calcular um imposto ou ordenar uma lista.
Mas alguns problemas são bagunçados demais para regras. O que exatamente faz um apartamento valer R$ 650 mil e não R$ 580 mil? O tamanho, o número de quartos, o bairro, o estado de conservação, a vista... e o jeito como tudo isso se combina é complicado. Escrever tudo à mão seria quase impossível.
O aprendizado de máquina segue outro caminho. Você dá ao computador muitos exemplos em que a resposta já é conhecida, e ele descobre os padrões sozinho:
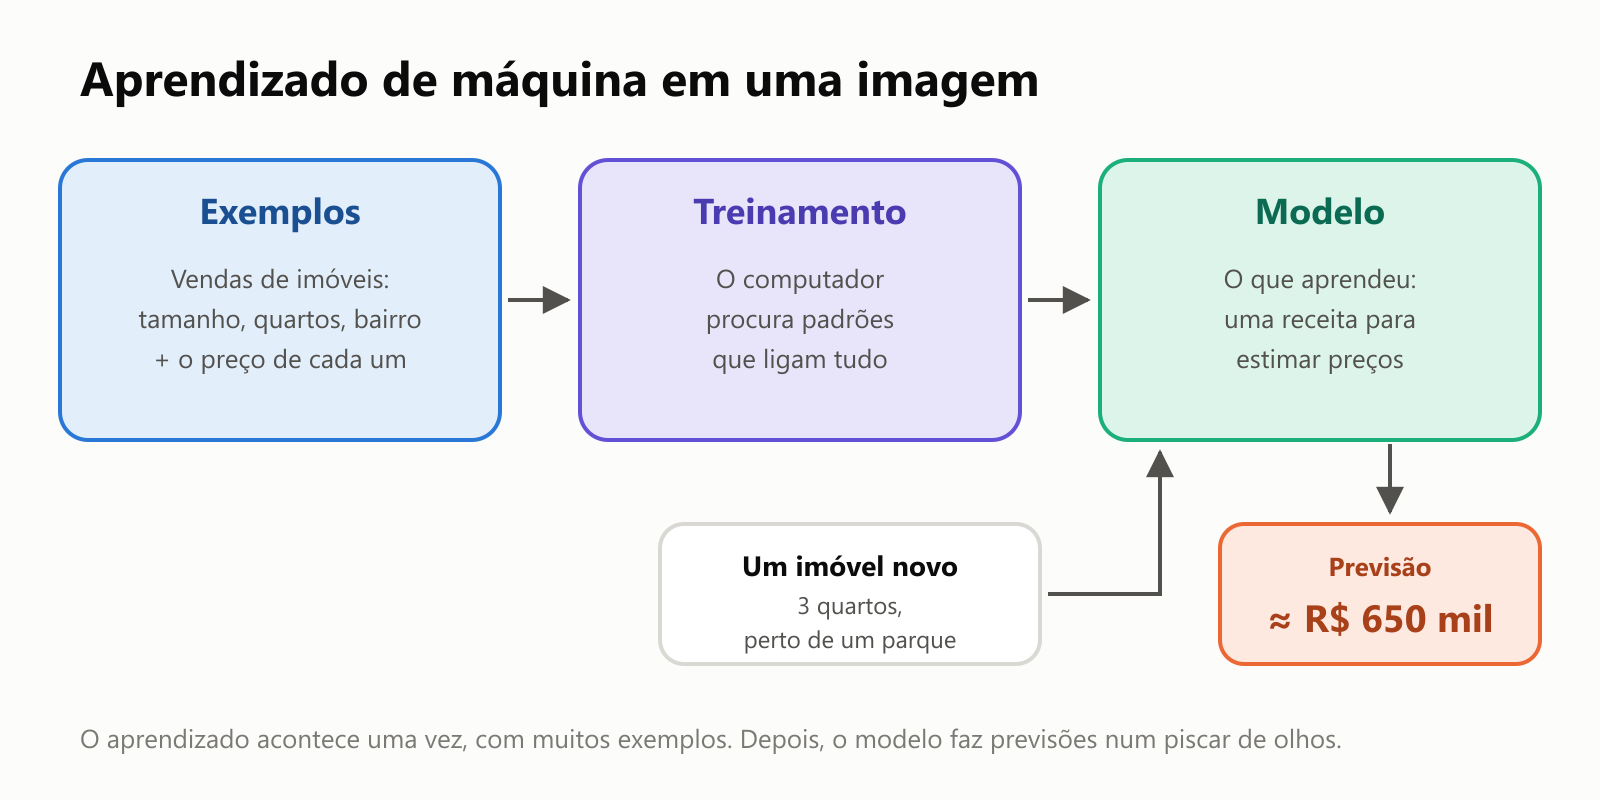
Três palavras-chave aqui:
- Dados (ou exemplos): os casos do passado com que o computador aprende.
- Treinamento: o processo de encontrar padrões nesses dados.
- Modelo: o que o computador obtém no final, uma espécie de receita que transforma informações novas numa previsão.
O termo "aprendizado de máquina" vem de 1959, quando um pesquisador da IBM chamado Arthur Samuel o usou para descrever um programa de damas que melhorava jogando contra si mesmo.
O modelo mais simples: traçar uma reta
Vamos ver o treinamento em ação com o modelo mais simples que existe. Imagine que você tem uma pizzaria e quer dar preço a uma pizza nova, maior. Estes são os seus preços atuais (inventados para o exemplo):
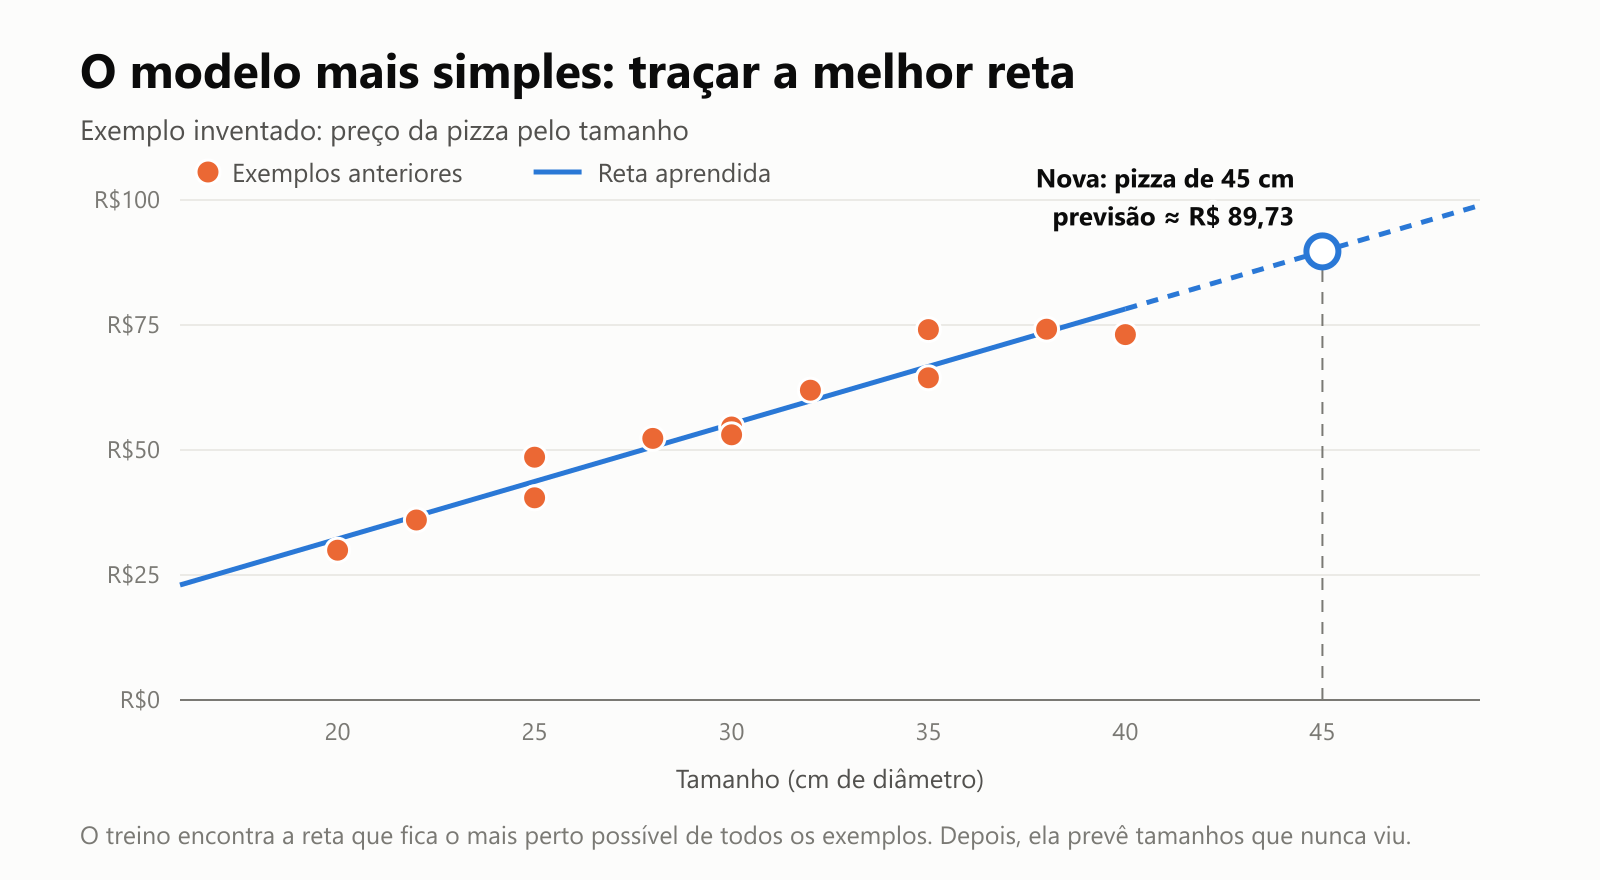
Treinar, aqui, é encontrar a reta que fica o mais perto possível de todos os pontos. O computador testa inclinações e alturas diferentes e fica com a que tem o menor erro total. (É um cálculo de verdade, o mesmo que as planilhas fazem quando você adiciona uma "linha de tendência".)
Com a reta pronta, o modelo consegue fazer previsões para tamanhos que nunca viu, como uma pizza de 45 cm. Esse é todo o propósito do aprendizado de máquina: aprender com o passado, prever o novo.
Modelos reais trabalham com muito mais informações do que uma só (tamanho, sabor, bairro, dia da semana...) e com formas muito mais complicadas do que uma reta. Mas a ideia é exatamente a mesma.
Três jeitos de as máquinas aprenderem
O aprendizado de máquina tem três tipos principais, dependendo dos exemplos que você tem:
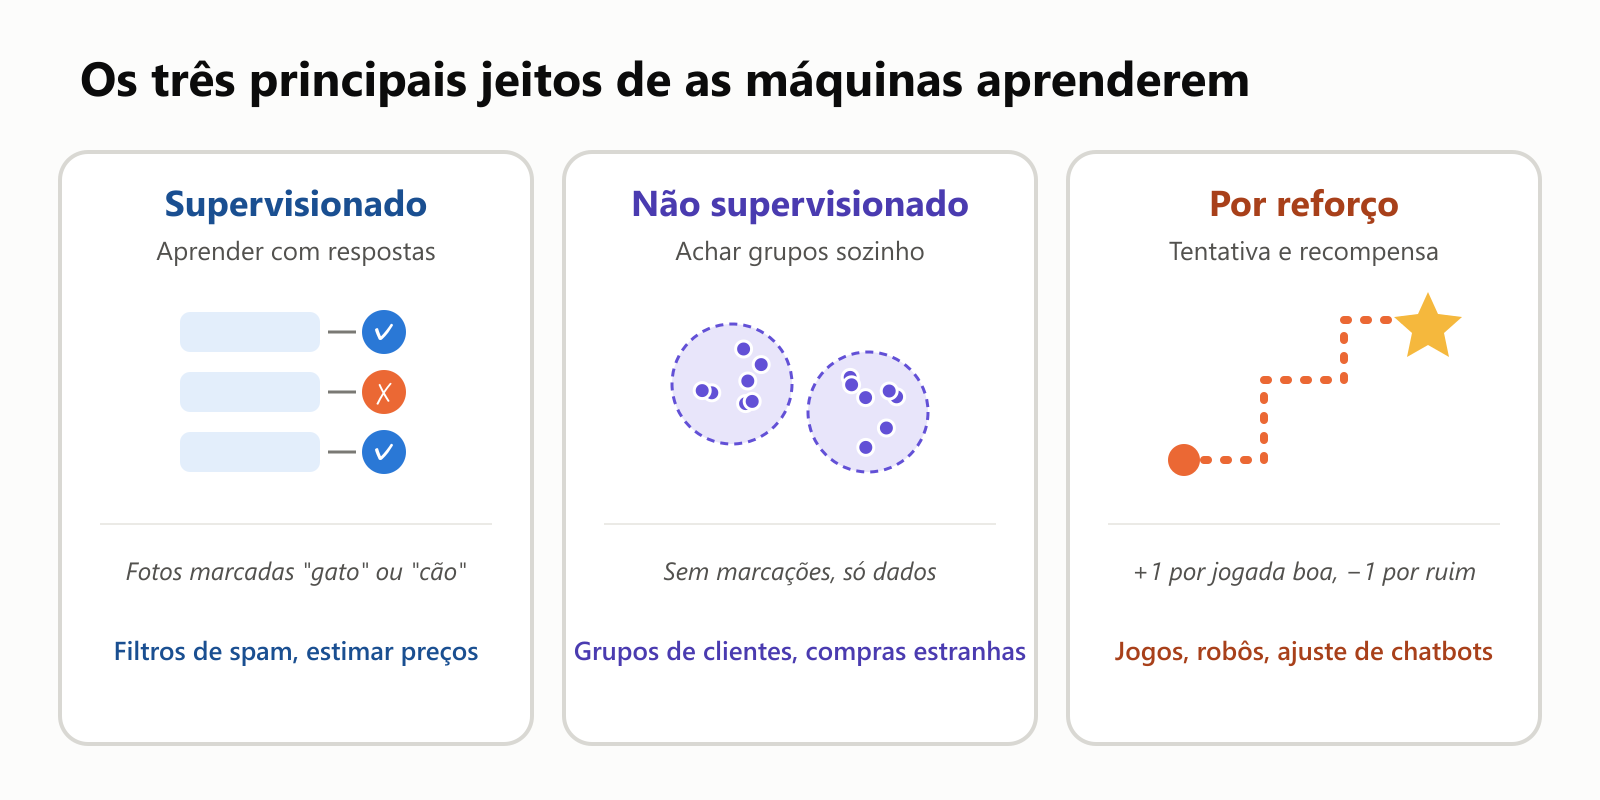
1. Aprendizado supervisionado: aprender com as respostas
Os exemplos vêm com as respostas certas, como um aluno estudando com o gabarito. "Este e-mail é spam. Este não é." "Este apartamento foi vendido por R$ 500 mil." É de longe o tipo mais comum, e faz dois tipos principais de trabalho:
- Classificação: escolher uma categoria. Spam ou não? Gato ou cão? Fraude ou normal?
- Regressão: prever um número. Qual preço? Quantos minutos? Quanta chuva?
2. Aprendizado não supervisionado: achar padrões sozinho
Aqui não há resposta nenhuma, só dados. O trabalho do computador é encontrar alguma estrutura por conta própria, como grupos de coisas parecidas. Uma loja pode não ter ideia de como os seus clientes se dividem naturalmente, então deixa o computador procurar:
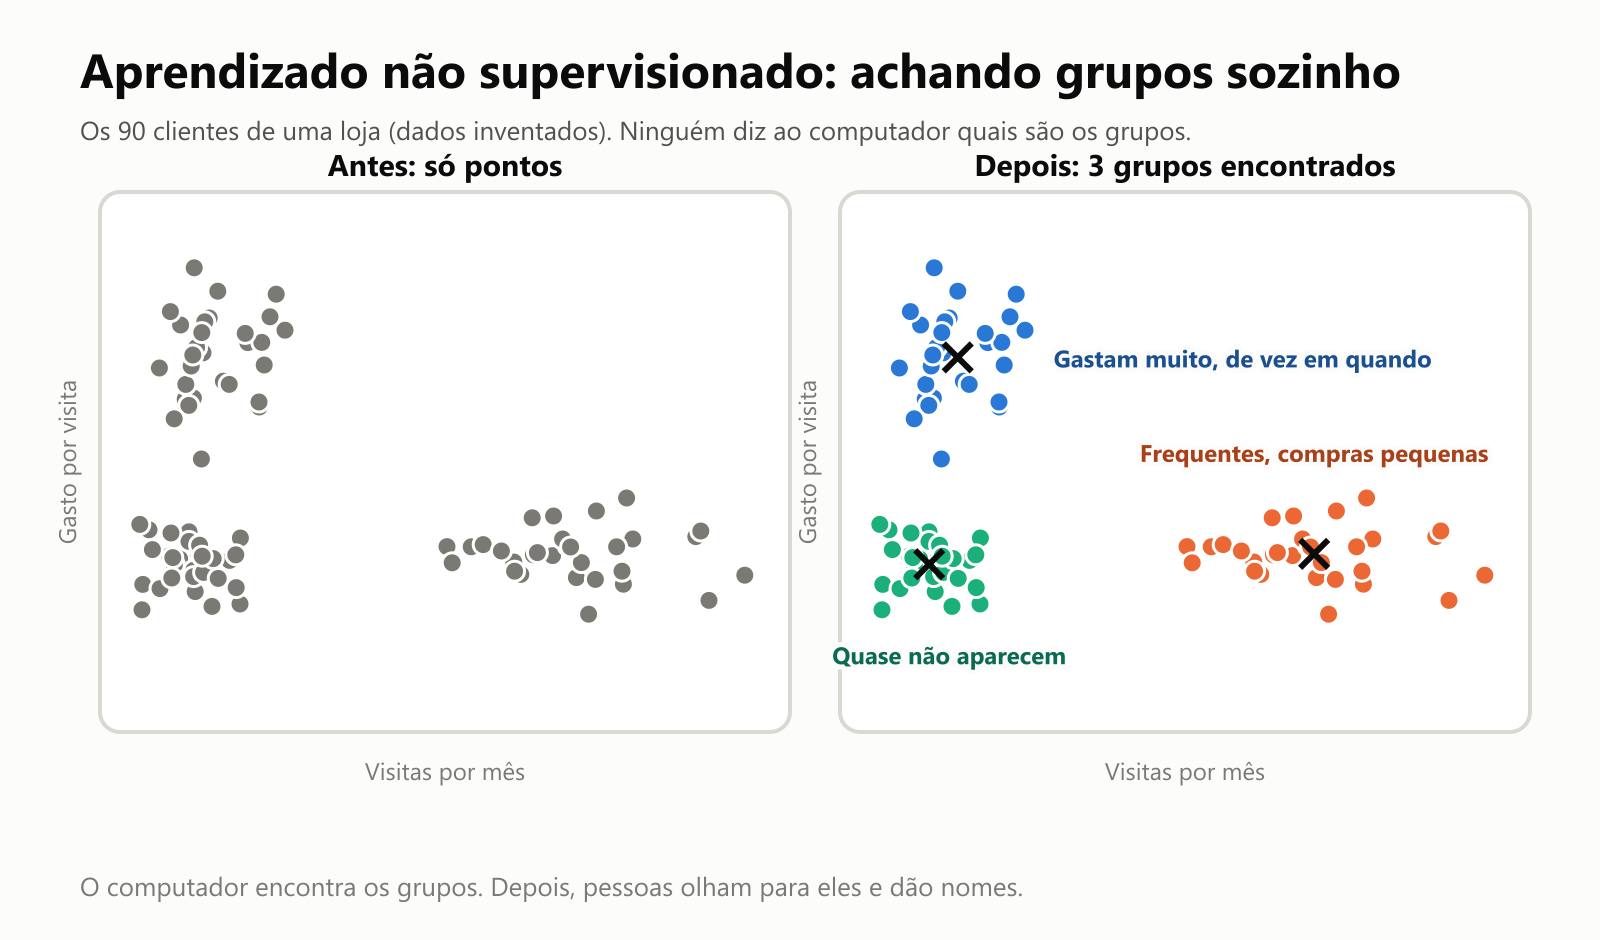
Ninguém disse ao computador que havia três tipos de clientes. Ele encontrou os grupos, e depois pessoas olharam para eles e deram nomes. (É um resultado real de um método popular chamado k-means, ou agrupamento por k-médias, rodado com dados inventados.) A mesma ideia ajuda a identificar atividades incomuns, como um cartão de crédito de repente sendo usado de um jeito estranho.
3. Aprendizado por reforço: aprender por tentativa e recompensa
Aqui o computador aprende fazendo. Ele tenta ações, ganha uma recompensa quando as coisas vão bem e uma penalidade quando não vão, e aos poucos descobre o que funciona. É como adestrar um cachorro com petiscos.
O aprendizado por reforço ensinou computadores a jogar Go e xadrez em nível sobre-humano, ajuda robôs a aprender a andar e pegar objetos, e é uma das etapas usadas para deixar os chatbots de IA mais úteis, recompensando as respostas que as pessoas preferem.
A maior armadilha: decorar em vez de aprender
Imagine um aluno que decora as respostas de todos os simulados, mas nunca entende a matéria. Ele gabarita os simulados e depois vai mal na prova de verdade, porque as perguntas são diferentes.
Modelos de aprendizado de máquina podem fazer exatamente a mesma coisa. Isso se chama sobreajuste (em inglês, overfitting), e é uma das ideias mais importantes da área. Veja três modelos aprendendo com os mesmos 12 pontos de exemplo:
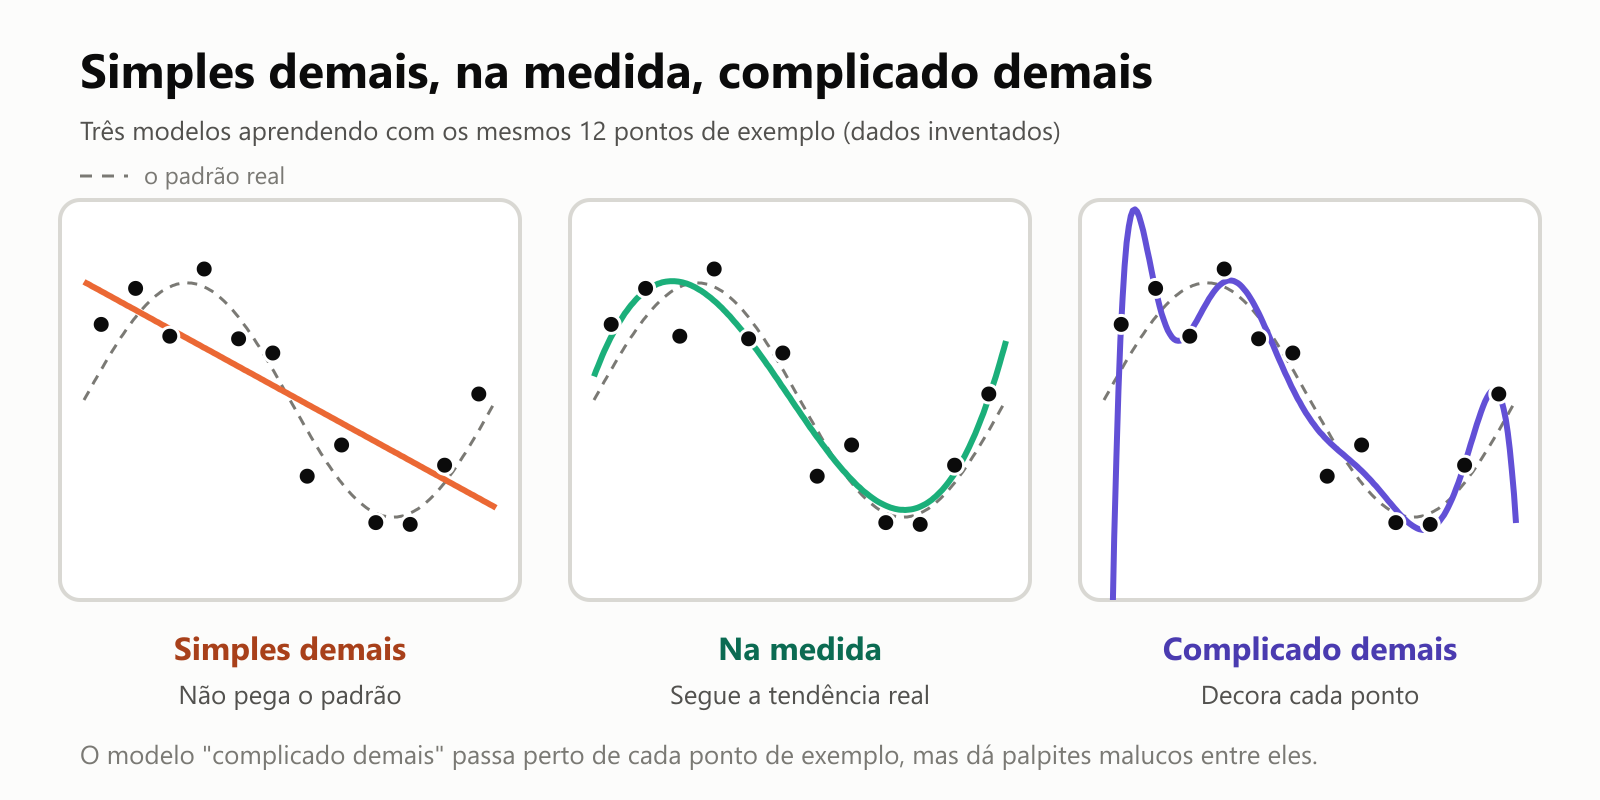
- Simples demais: uma reta não consegue fazer curvas, então não pega o padrão real em forma de onda. Isso se chama subajuste (underfitting).
- Na medida: um modelo com uma curvatura suave segue a tendência real e ignora o ruído aleatório.
- Complicado demais: um modelo com muita liberdade se dobra todo para passar perto de cada ponto, ruído incluído. Ele "decorou" os exemplos, e os palpites dele entre os pontos são malucos.
Veja como isso aparece nos números. Medimos o erro médio de cada modelo nos 12 exemplos com que ele aprendeu e em 100 pontos novos, que ele nunca viu:
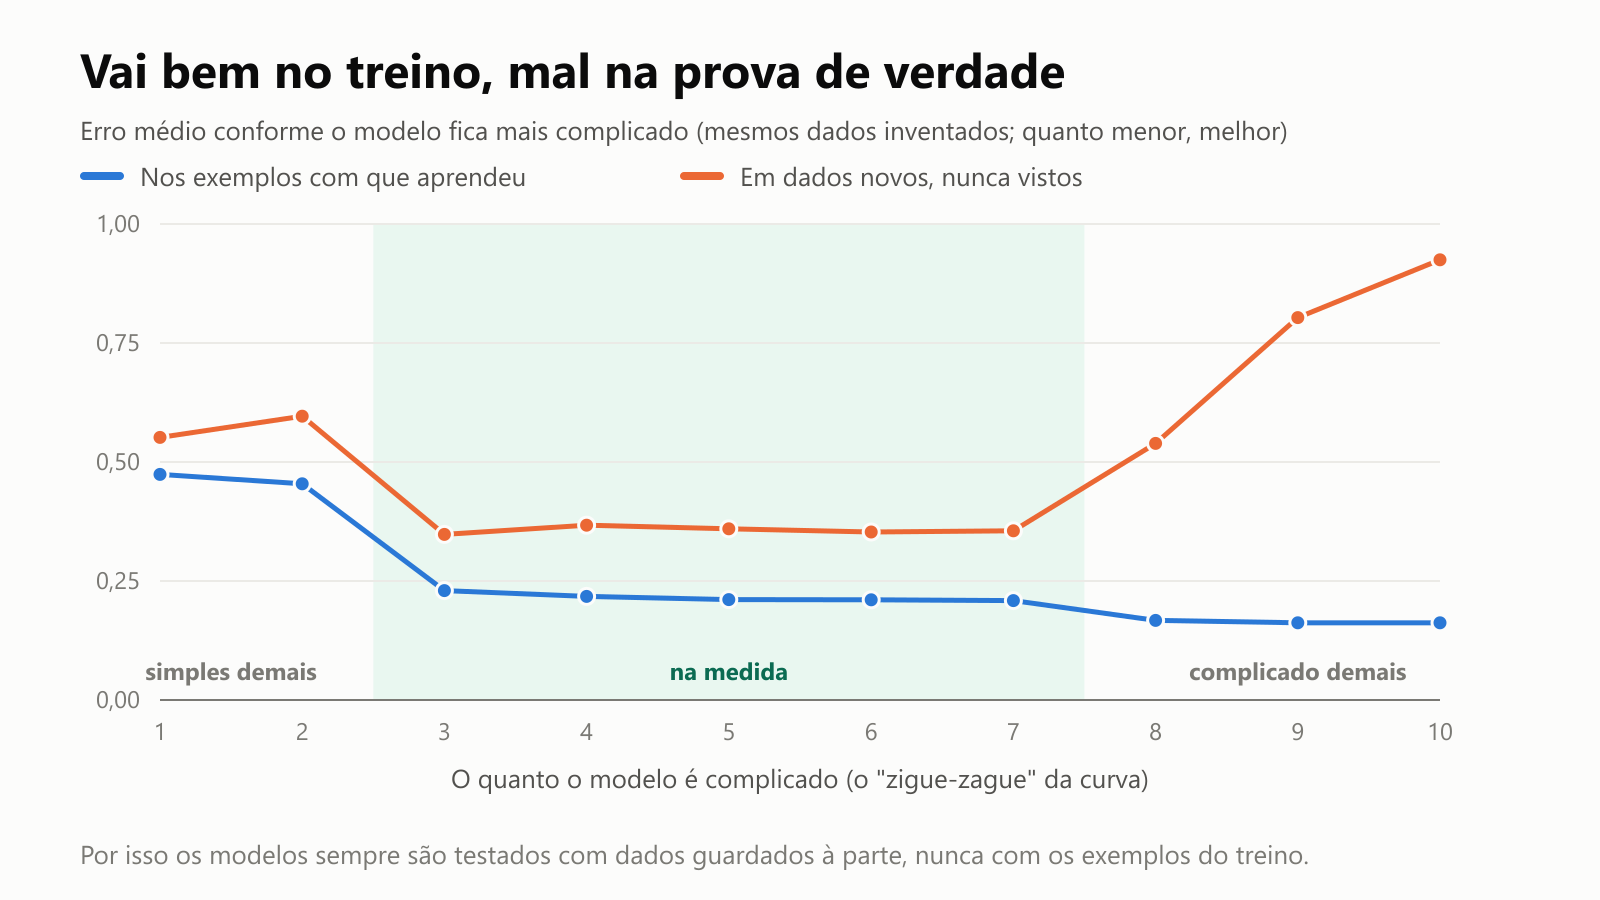
A linha azul (os simulados) melhora sempre, conforme o modelo fica mais complicado. A linha laranja (a prova de verdade) melhora no começo e depois piora muito. Ir bem nos exemplos do treino prova muito pouco.
Como saber se um modelo é bom?
A medida óbvia é a taxa de acerto (acurácia): em quantos por cento das vezes ele acerta? Mas ela pode enganar feio, principalmente quando você procura algo raro.
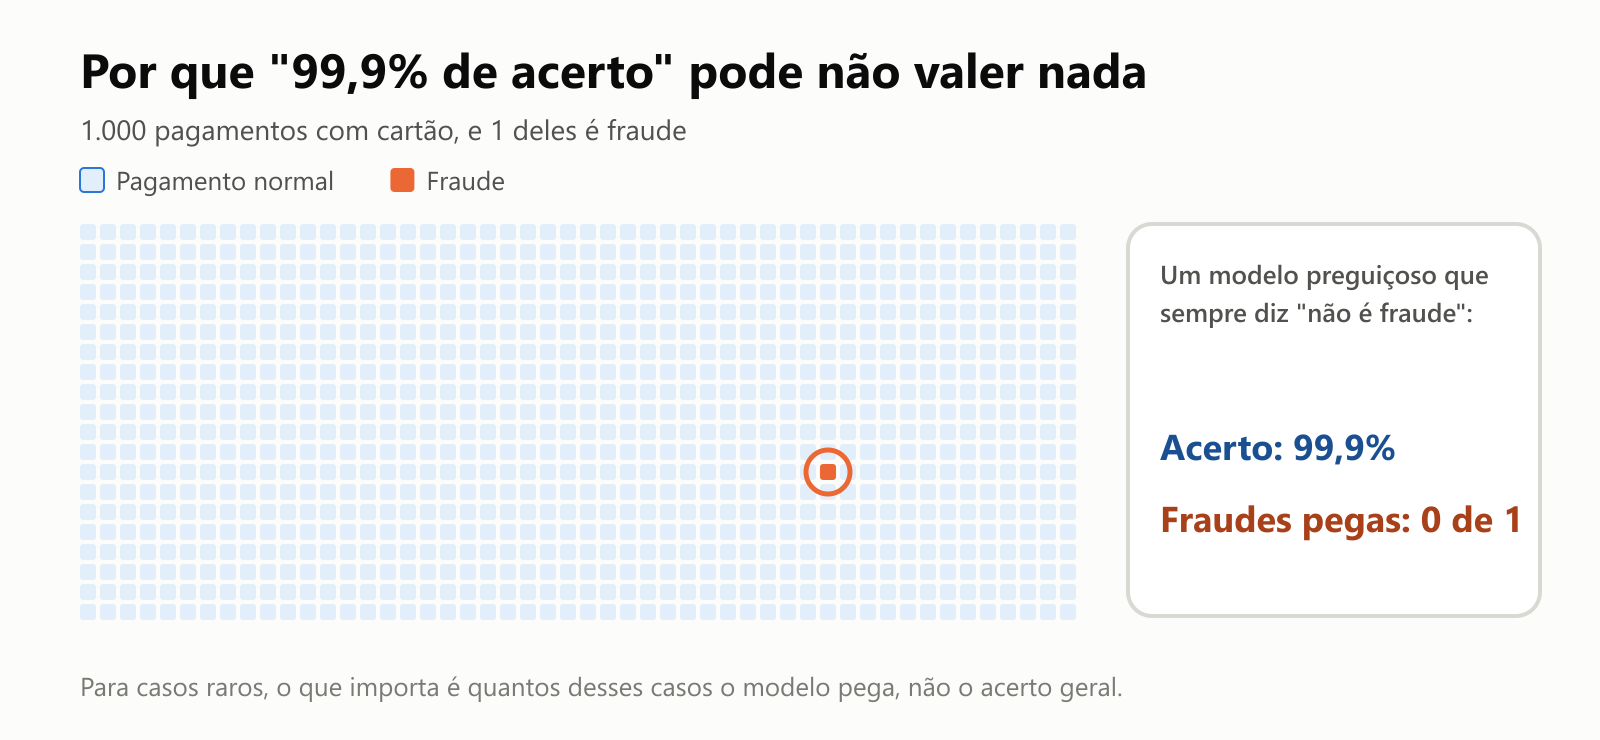
Um "modelo" que simplesmente diz "não é fraude" toda vez acertaria 999 de cada 1.000. São 99,9% de acerto, e ele é totalmente inútil, porque nunca pega fraude nenhuma.
Por isso, quem constrói modelos também pergunta coisas como:
- Das fraudes reais, quantas ele pegou? (Deixar fraude passar custa caro.)
- Dos pagamentos que ele bloqueou, quantos eram mesmo fraude? (Alarme falso demais, e os clientes ficam irritados com o cartão bloqueado.)
Qual erro importa mais depende do trabalho. Um exame médico de triagem deve quase nunca deixar passar uma doença, mesmo que isso gere alguns alarmes falsos. Um filtro de spam deve quase nunca jogar fora um e-mail de verdade, mesmo que um pouco de spam passe.
Lixo entra, lixo sai
Um modelo só pode ser tão bom quanto os exemplos com que aprendeu (veja O Que É Rotulagem de Dados? para entender como esses exemplos ganham as respostas). Alguns problemas comuns:
- Poucos dados: algumas dezenas de exemplos raramente mostram o padrão real.
- Dados errados ou bagunçados: erros de digitação, exemplos marcados errado e informações faltando ensinam as lições erradas.
- Dados que não representam a realidade: um modelo treinado só com vendas de verão vai se confundir no inverno. Um sistema de reconhecimento facial treinado principalmente com um grupo de pessoas funciona pior para outros.
- Preconceitos do passado: se decisões antigas eram injustas, como quem conseguia um empréstimo, um modelo treinado com elas pode aprender e repetir essa injustiça.
- O mundo muda: hábitos, preços e golpes mudam com o tempo, então modelos precisam ser conferidos e retreinados.
Aprendizado de máquina à sua volta
| Onde você vê | O que o modelo faz | Tipo |
|---|---|---|
| Filtro de spam | Spam ou não? | Supervisionado (classificação) |
| Estimativa de preço de imóveis | Prevê um preço | Supervisionado (regressão) |
| Alertas de fraude do banco | Marca pagamentos incomuns | Supervisionado e não supervisionado |
| Sugestões de músicas e vídeos | Prevê do que você vai gostar | Supervisionado, com base no que pessoas parecidas curtiram |
| Grupos de clientes de uma loja | Encontra grupos de clientes parecidos | Não supervisionado |
| Previsão de tempo de entrega | Prevê os minutos até a chegada | Supervisionado (regressão) |
| IA que joga e robôs | Aprende quais ações dão recompensa | Por reforço |
| Chatbots de IA | Aprendem a linguagem com textos e depois são ajustados com feedback | Vários tipos combinados |
Um pequeno glossário
- Aprendizado de máquina: computadores aprendendo padrões com exemplos, em vez de seguir regras escritas à mão.
- Dados: os exemplos com que um modelo aprende.
- Atributo (feature): uma informação sobre um exemplo, como o tamanho de um imóvel ou o número de quartos.
- Rótulo (label): a resposta certa ligada a um exemplo, como "spam" ou um preço de venda.
- Treinamento: o processo de encontrar padrões nos dados.
- Modelo: o resultado do treinamento, que transforma informações novas em previsões.
- Previsão: a resposta do modelo para um caso novo.
- Aprendizado supervisionado: aprender com exemplos que trazem as respostas certas.
- Aprendizado não supervisionado: encontrar estrutura, como grupos, em dados sem respostas.
- Aprendizado por reforço: aprender por tentativa e erro, guiado por recompensas.
- Classificação: prever uma categoria. Regressão: prever um número.
- Sobreajuste (overfitting): decorar os exemplos do treino em vez de aprender o padrão geral.
- Dados de teste: exemplos guardados à parte para ver como o modelo se sai com coisas que nunca viu.
- Viés: padrões injustos ou desequilibrados que um modelo absorve dos dados.
Concluindo
O aprendizado de máquina é uma ideia simples com consequências enormes: em vez de dizer ao computador exatamente o que fazer, você mostra muitos exemplos e deixa que ele encontre os padrões. O aprendizado supervisionado aprende com exemplos que têm respostas, o não supervisionado encontra grupos sozinho, e o por reforço aprende por tentativa e recompensa.
A arte está nos detalhes: ter dados bons e justos, evitar modelos que decoram em vez de aprender, testar com exemplos que o modelo nunca viu e medir os erros que realmente importam. Acertando isso, o aprendizado de máquina consegue pegar fraudes, recomendar uma ótima música ou estimar um preço num piscar de olhos. E agora você sabe o que acontece nos bastidores quando ele faz isso.
Read next
O Que É Aprendizado por Reforço? Como a IA Aprende com Tentativa, Erro e Recompensa
Uma introdução simples e sem jargões ao aprendizado por reforço, o jeito como a IA aprende com tentativa, erro e recompensa, como um cachorro aprendendo com petiscos. Veja um robô aprender um labirinto e como isso molda os chatbots.
 nbkhope
O Que É Engenharia de Grafos? Como a IA Trabalha em Equipe para Fazer Coisas de Verdade
Um guia simples e sem jargões sobre engenharia de grafos, a ideia de 2026 de montar a IA como um mapa de etapas conectadas. Veja como os agentes de IA funcionam, por que pequenos erros se acumulam e como revisões e trabalho em equipe resolvem isso.
nbkhope
O Que É Engenharia de Loops? Como Agentes de IA Trabalham Até Terminar o Serviço
Um guia simples e sem jargões sobre engenharia de loops, a ideia de 2026 de projetar o ciclo em que um agente de IA trabalha até terminar o serviço, com objetivos claros, feedback real, regras de parada e a hora de chamar uma pessoa.
nbkhope
Comentários
Be kind and specific. Comments with links from new accounts appear after a moderator reviews them.