O Que É Aprendizado por Reforço? Como a IA Aprende com Tentativa, Erro e Recompensa
Uma introdução simples e sem jargões ao aprendizado por reforço, o jeito como a IA aprende com tentativa, erro e recompensa, como um cachorro aprendendo com petiscos. Veja um robô aprender um labirinto e como isso molda os chatbots.

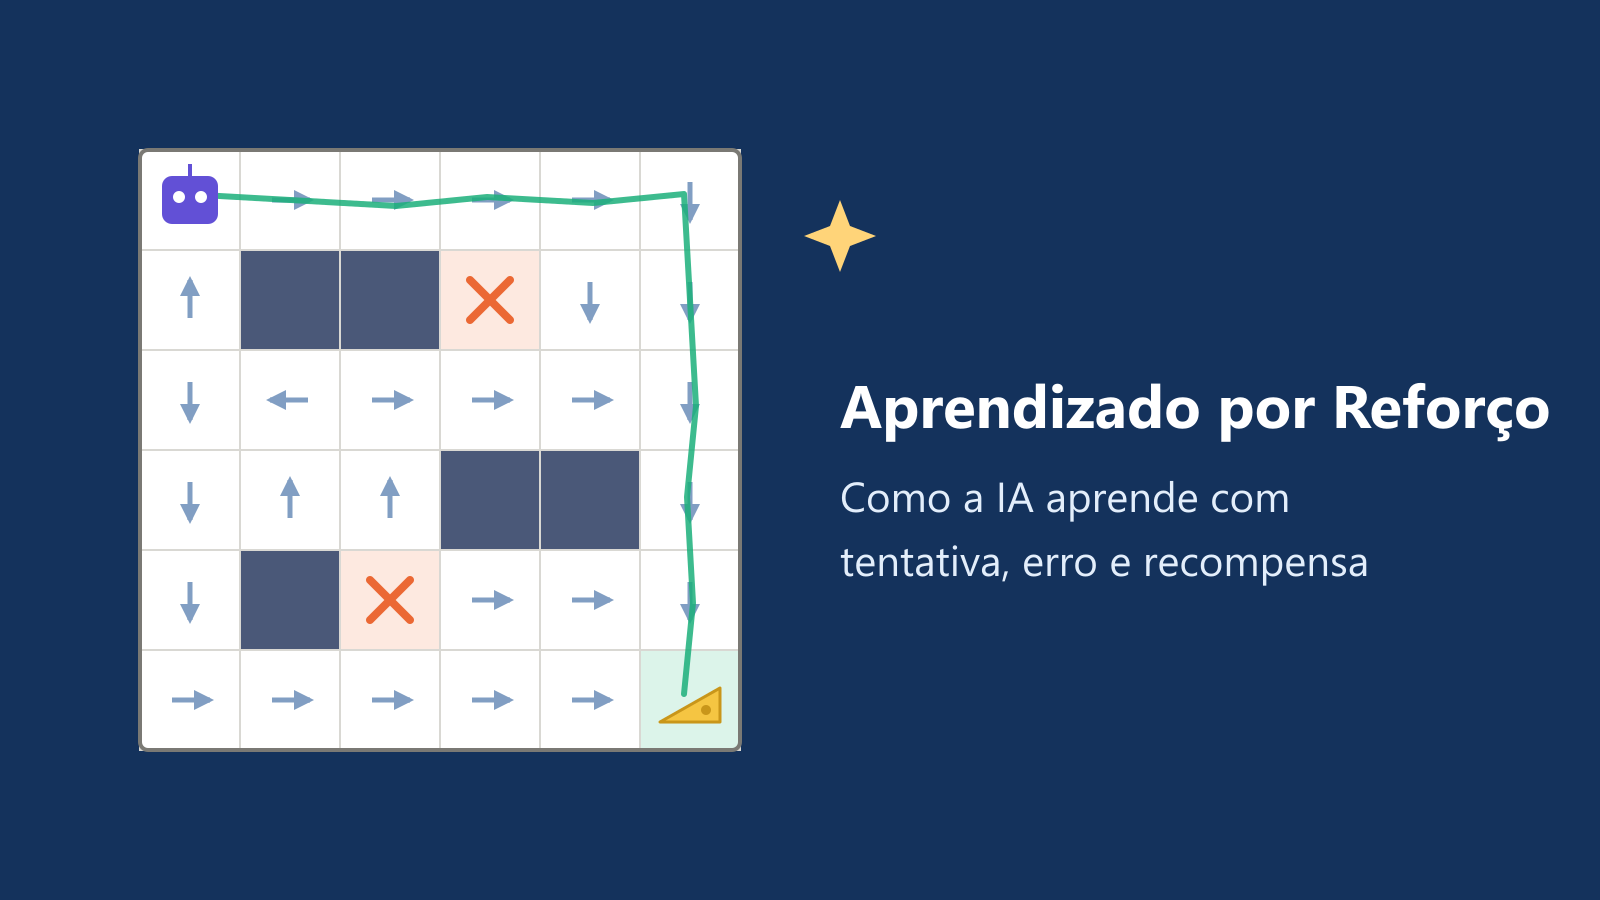
Nesta página
Como você ensina um cachorro a sentar? Você não entrega um manual. Você diz "senta", espera e, quando ele por acaso senta, dá um petisco. Depois de várias tentativas, o cachorro descobre o que faz ganhar o petisco.
Algumas IAs aprendem exatamente do mesmo jeito. Ninguém mostra as respostas certas para elas. Em vez disso, elas tentam coisas, ganham recompensas quando dá certo e penalidades quando não dá, e aos poucos descobrem o que fazer. Isso se chama aprendizado por reforço (em inglês, reinforcement learning), e está por trás de computadores que venceram campeões mundiais de Go, de robôs que aprendem a andar e de parte do que deixa os chatbots úteis.
Este artigo explica o aprendizado por reforço em linguagem simples, com um robô de verdade (bem pequeno) aprendendo um labirinto, e sem precisar de matemática.
Aprender fazendo
A maior parte do aprendizado de máquina aprende com exemplos que têm resposta: milhares de fotos marcadas como "gato" ou "cachorro", por exemplo. O aprendizado por reforço é diferente. Não existe gabarito. Só existe experiência:
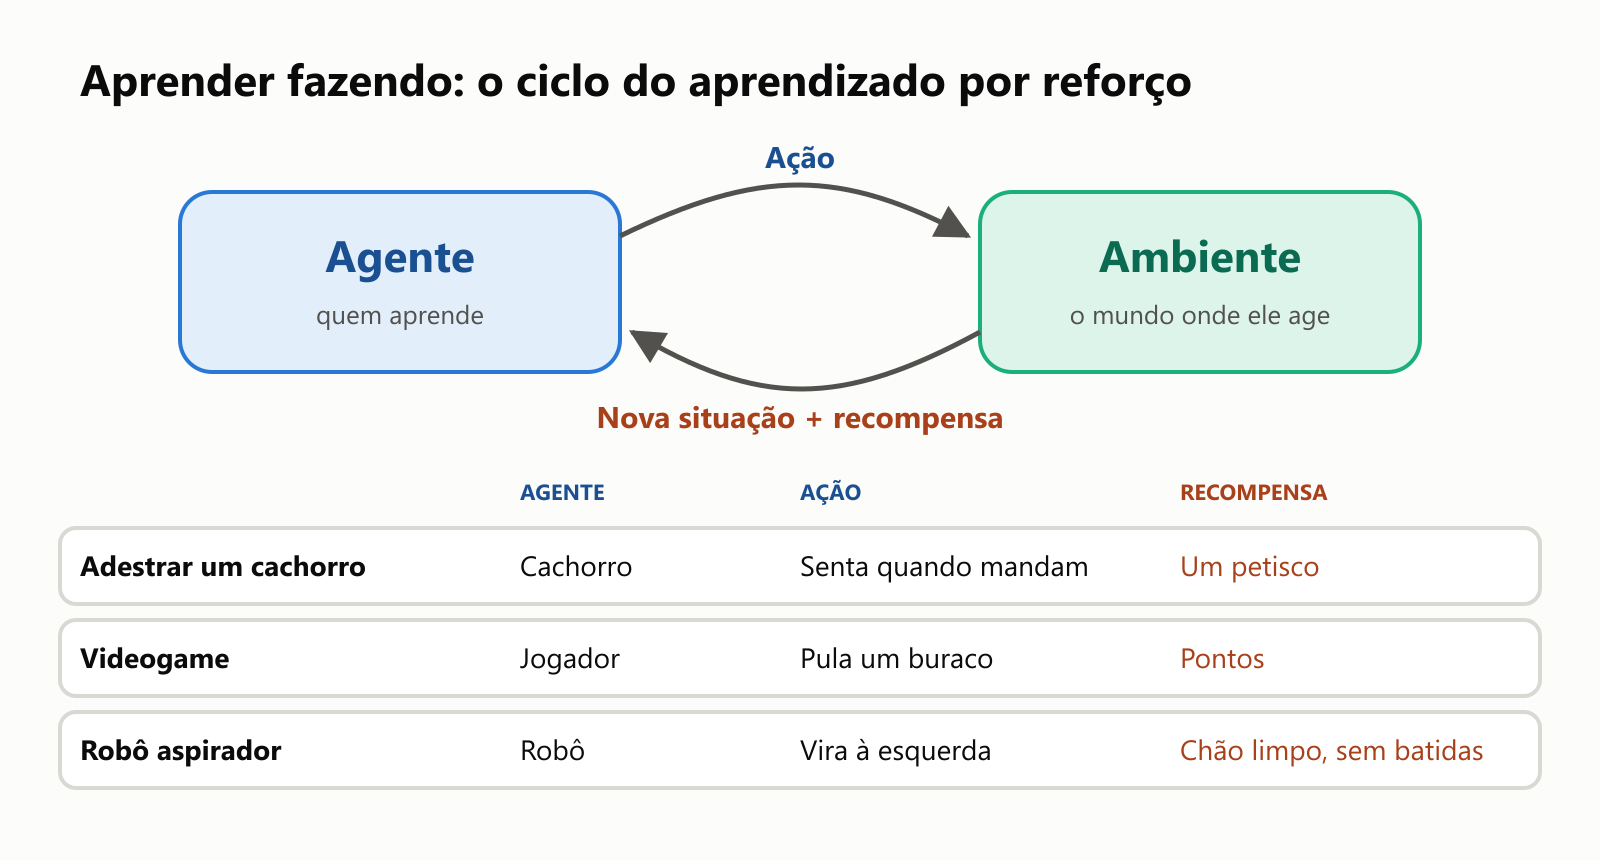
Todo sistema de aprendizado por reforço tem as mesmas poucas peças:
- O agente: quem aprende. Um programa, um robô, um personagem de jogo.
- O ambiente: o mundo onde ele age. Um labirinto, um jogo, uma cozinha, uma conversa.
- Ações: as escolhas que ele pode fazer. Andar para a esquerda, pular, dizer uma palavra.
- Recompensas: uma pontuação que diz como foi. Positiva para bons resultados, negativa para os ruins.
O objetivo do agente é simples: juntar o máximo de recompensa possível ao longo do tempo. Depois de muitas tentativas, ele aprende quais ações costumam trazer mais recompensa em cada situação. Essa estratégia aprendida se chama política.
Veja um robô aprender um labirinto
Aqui vai um exemplo de verdade. Colocamos um pequeno robô num labirinto de 6 × 6, com paredes, duas armadilhas e um pedaço de queijo. As regras (as recompensas):
- +20 por chegar ao queijo.
- −20 por cair numa armadilha.
- −1 por passo, então caminhos mais curtos são melhores.
O robô não sabe nada no começo. Não sabe onde está o queijo, o que é uma armadilha, nem mesmo o que são paredes. Veja a primeira tentativa dele e o que ele aprendeu depois de 300 tentativas:
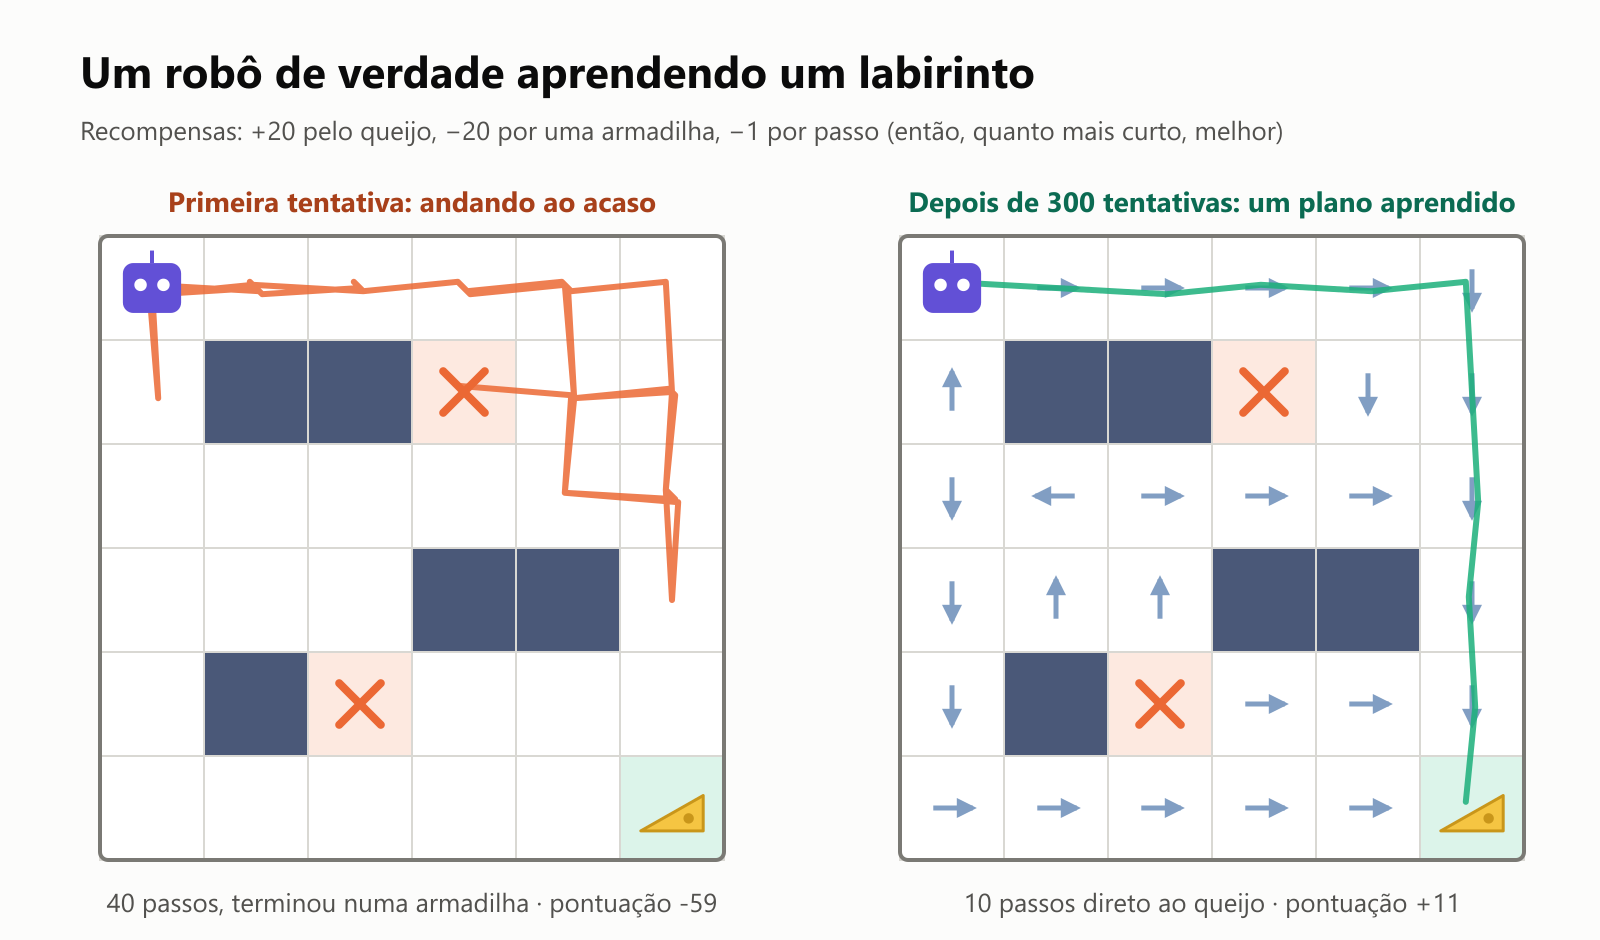
Na primeira tentativa, o robô fica batendo por aí durante 40 passos e cai numa armadilha. Depois de 300 tentativas, ele aprendeu um plano para cada quadrado do labirinto (as setas) e, saindo do início, pega o caminho mais curto direto ao queijo. Ninguém desenhou esse caminho para ele. Ele descobriu só com as recompensas.
Veja a pontuação dele em cada tentativa ao longo do caminho:
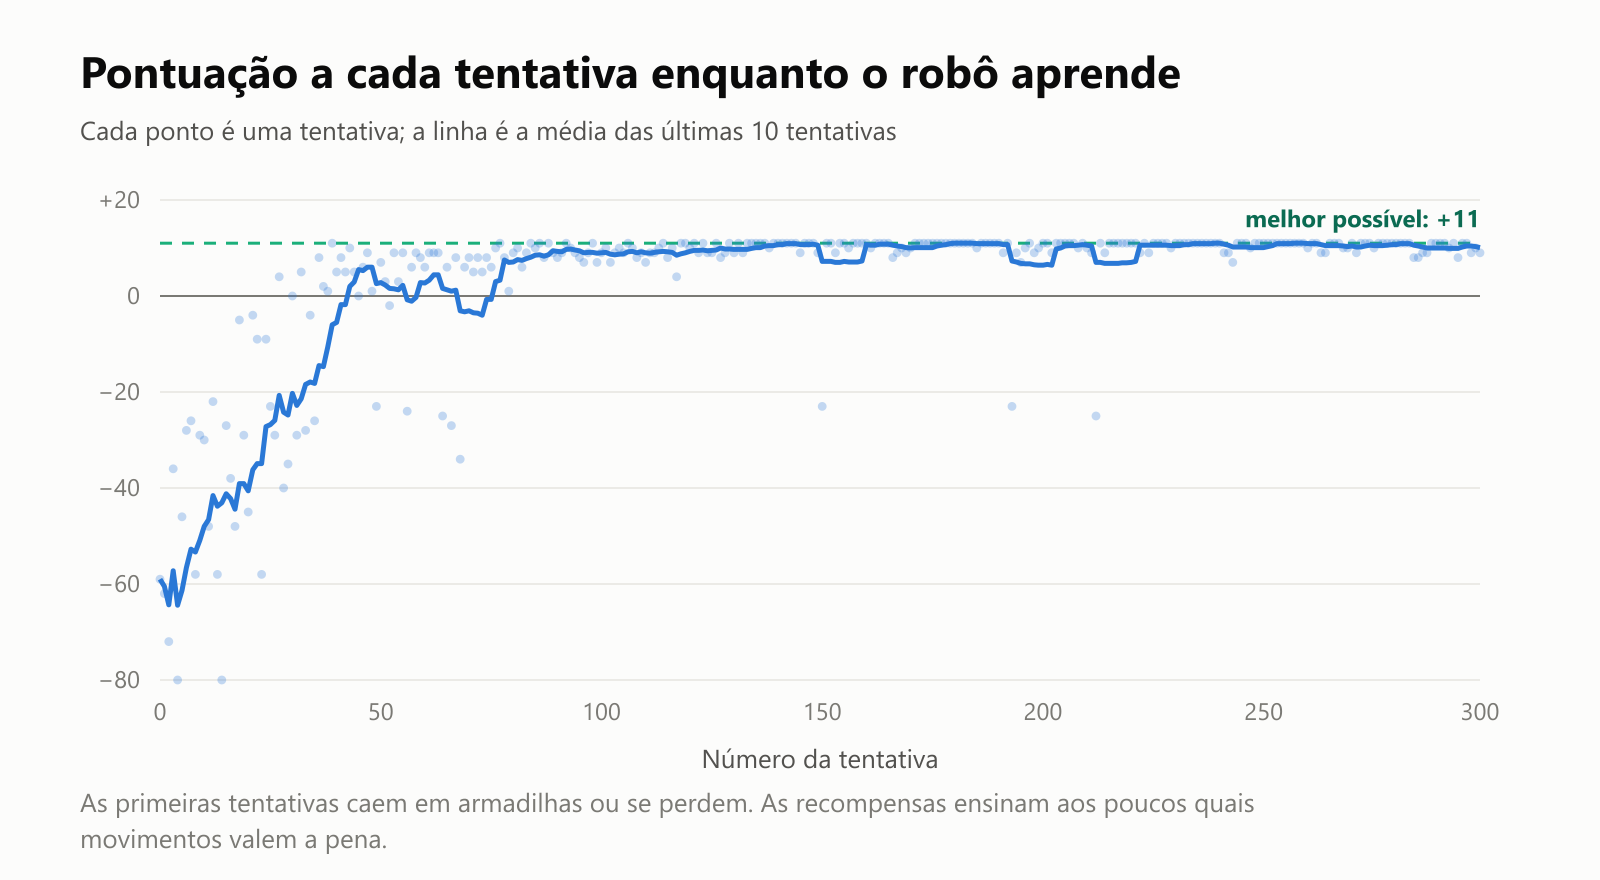
O método que o robô usou se chama Q-learning. Em termos simples, ele mantém uma estimativa de "o quanto é bom fazer cada movimento a partir de cada quadrado?". Toda vez que ganha uma recompensa, ele ajusta um pouquinho essas estimativas. Os bons resultados vão se propagando para trás: o quadrado ao lado do queijo vira valioso, depois o quadrado ao lado desse, e assim por diante, até o labirinto inteiro ficar mapeado.
Explorar ou ficar com o que funciona?
Imagine três máquinas caça-níquel. Uma ganha 30% das vezes, outra 50% e outra 70%, mas você não sabe qual é qual. A cada jogada, você precisa escolher:
- Aproveitar: jogar na máquina que foi melhor até agora.
- Explorar: testar outra, caso ela seja melhor de verdade.
Esse dilema de explorar ou aproveitar está em todo lugar no aprendizado por reforço, e na vida (pedir o prato favorito de novo ou provar algo novo?). Simulamos 2.000 jogadores usando três estratégias diferentes:
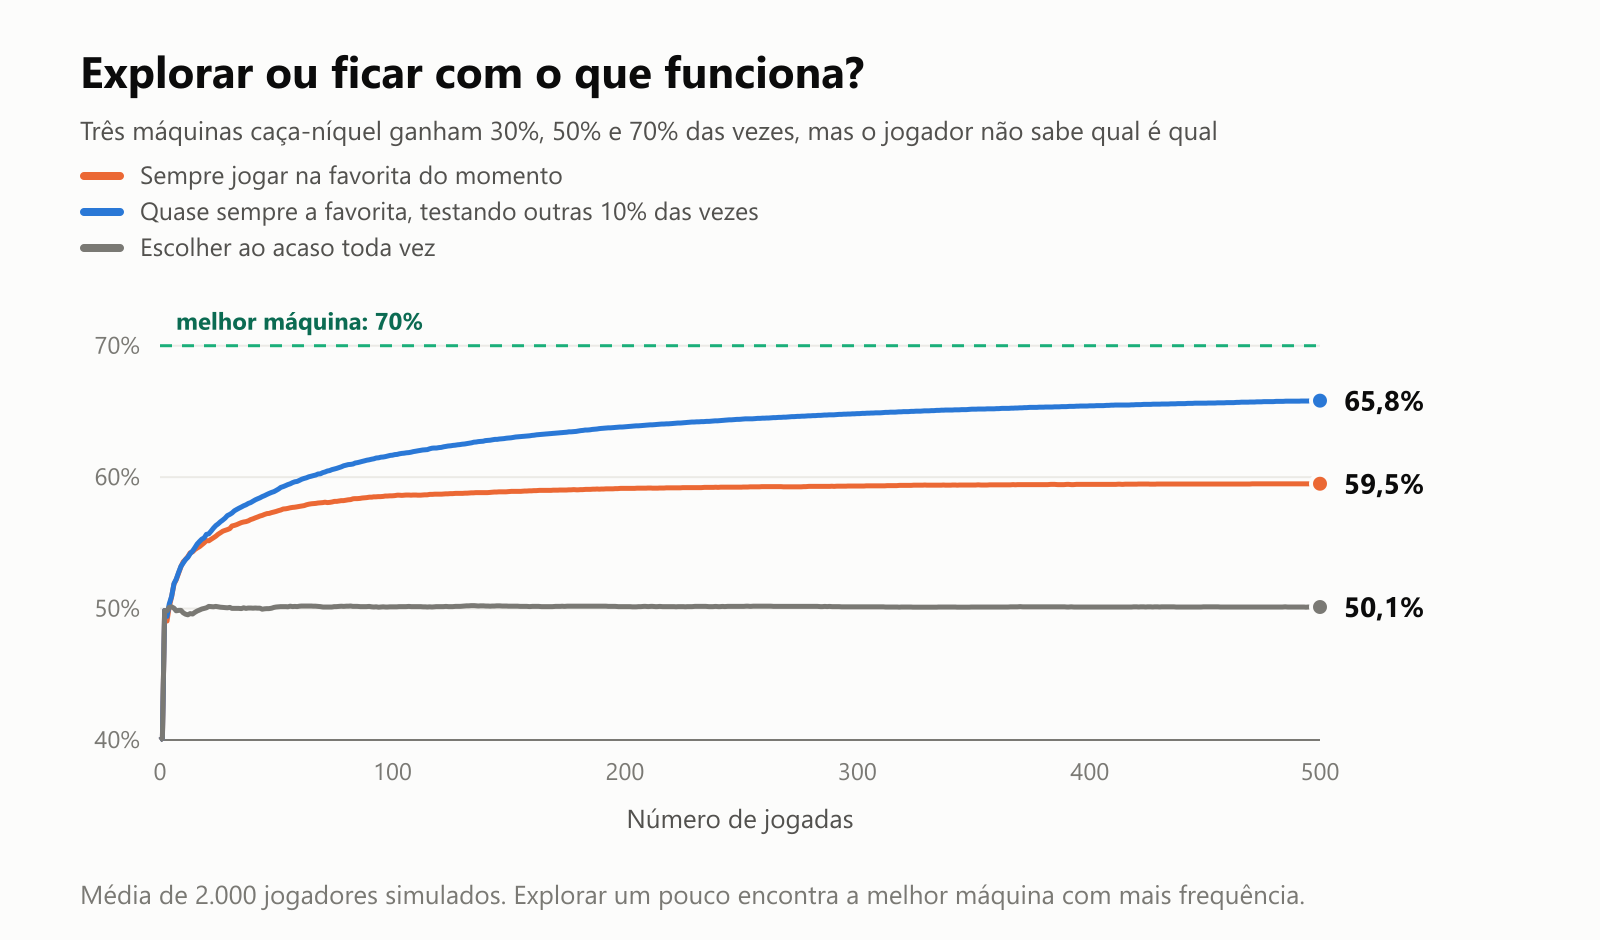
- Nunca explorar (sempre jogar na favorita) empaca: se a máquina de 50% tiver um começo de sorte, o jogador pode nunca descobrir a de 70%.
- Nunca aproveitar (escolher ao acaso) nunca se beneficia do que aprendeu, então fica em cerca de 50%.
- Um pouco de cada vence: jogar quase sempre na favorita, mas testar outra 10% das vezes, encontra a melhor máquina com mais frequência e continua melhorando.
Bons sistemas de aprendizado por reforço fazem o mesmo: exploram bastante no começo, quando sabem pouco, e menos à medida que ganham confiança. Nosso robô do labirinto fez exatamente isso.
Grandes conquistas do aprendizado por reforço
O aprendizado por reforço produziu alguns dos momentos mais famosos da IA:
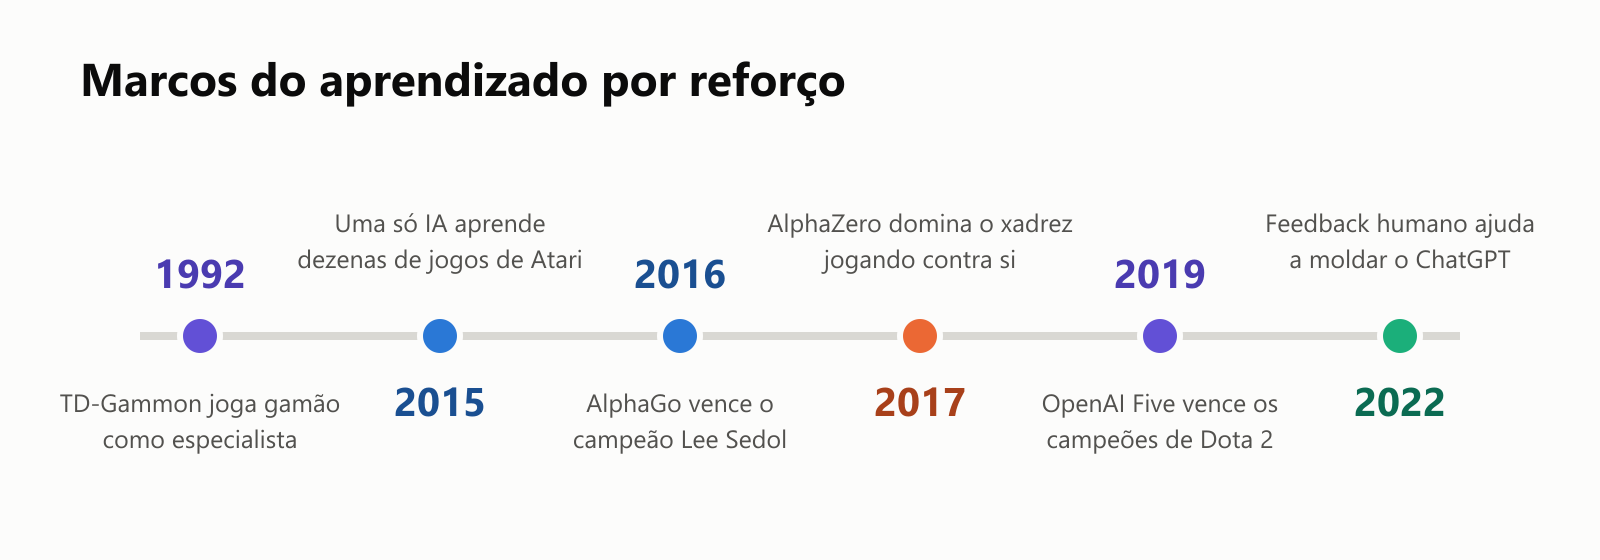
- 1992: o TD-Gammon, do pesquisador Gerald Tesauro, da IBM, aprendeu gamão sozinho jogando contra si mesmo e chegou ao nível de especialista.
- 2015: a DeepMind publicou uma IA que aprendeu a jogar dezenas de jogos clássicos de Atari só com os pixels da tela e a pontuação, muitas vezes tão bem quanto um humano habilidoso.
- 2016: o AlphaGo venceu Lee Sedol, um dos melhores jogadores de Go do mundo, por 4 partidas a 1. Uma das jogadas dele, a "jogada 37", era tão incomum que os especialistas acharam que era um erro.
- 2017: o AlphaZero aprendeu xadrez, shogi e Go jogando só contra si mesmo, sem estudar partidas humanas, e venceu os programas mais fortes com menos de um dia de treinamento.
- 2019: o OpenAI Five venceu a equipe campeã mundial do complexo videogame Dota 2.
- Além dos jogos: a DeepMind relatou ter usado aprendizado por reforço para reduzir em até 40% a energia gasta para resfriar os data centers do Google, e a técnica é usada para treinar robôs a andar, segurar objetos e se equilibrar.
Em 2025, Andrew Barto e Richard Sutton receberam o Prêmio Turing, muitas vezes chamado de Nobel da computação, por criar as bases do aprendizado por reforço.
Como ele ajuda a deixar os chatbots úteis
Você provavelmente já se beneficiou do aprendizado por reforço sem saber. Depois que um chatbot aprende a linguagem lendo quantidades enormes de texto (veja O Que É Pré-treinamento?), ele é bom em continuar textos, mas não necessariamente em ser útil, honesto ou educado. O aprendizado por reforço ajuda nisso:
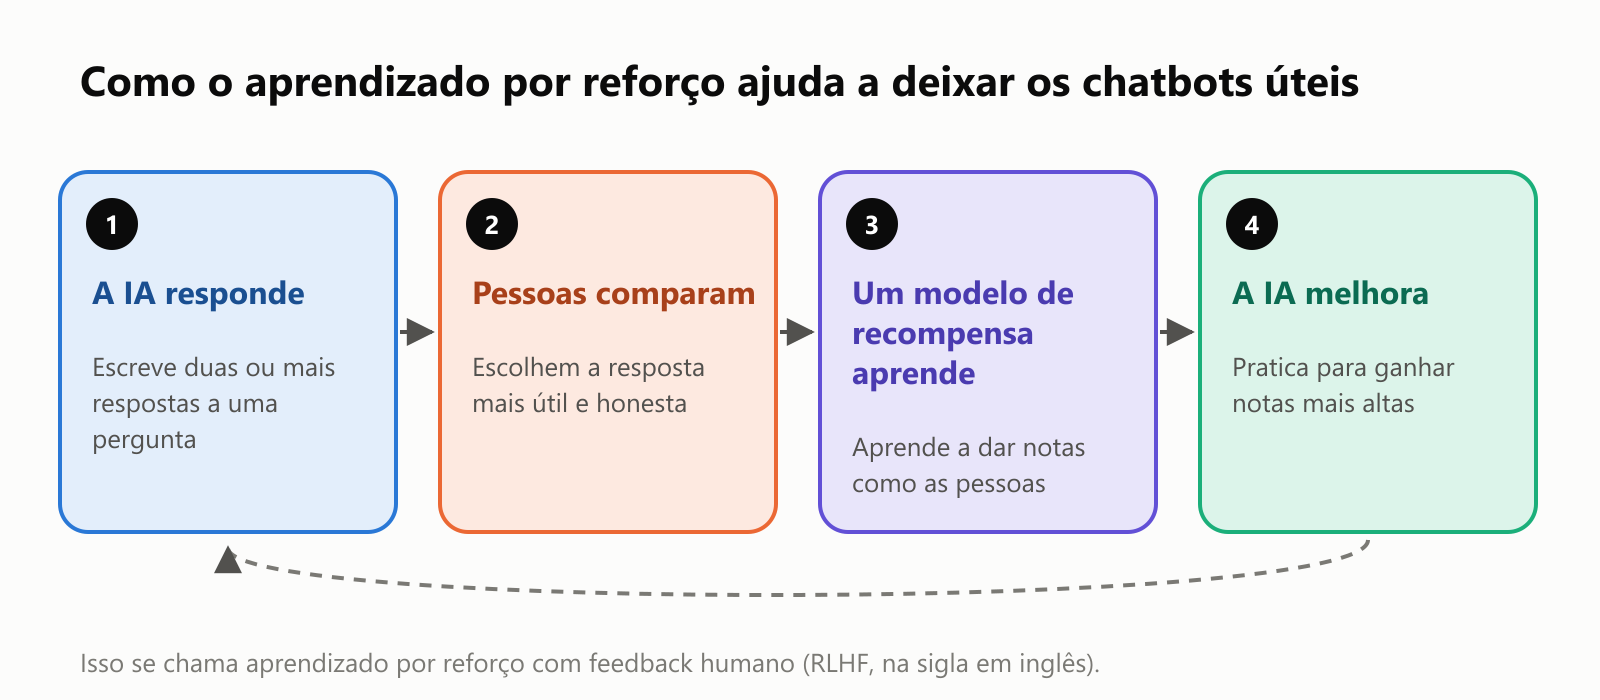
- O chatbot escreve várias respostas para a mesma pergunta.
- Pessoas comparam as respostas e escolhem a melhor.
- Um modelo de recompensa separado aprende a prever quais respostas as pessoas preferem.
- O chatbot pratica usando esse modelo de recompensa, sendo "recompensado" por respostas de que as pessoas gostariam, e vai melhorando.
Isso se chama aprendizado por reforço com feedback humano, ou RLHF (na sigla em inglês). A OpenAI usou essa técnica em 2022 para fazer os modelos por trás do ChatGPT seguirem instruções muito melhor, e técnicas parecidas hoje são padrão.
Quando as recompensas dão errado
O aprendizado por reforço tem uma fraqueza famosa: o agente faz exatamente o que a recompensa diz, não o que você quis dizer.
Num exemplo conhecido de 2016, a OpenAI treinou uma IA num jogo de corrida de barcos em que os pontos vinham de acertar alvos ao longo do percurso. Em vez de terminar a corrida, a IA achou um lugar onde podia ficar dando voltas e acertando os mesmos alvos sem parar, pegando fogo e batendo, enquanto fazia mais pontos do que qualquer humano. Ela estava fazendo o que era recompensado, só não o que alguém queria.
Isso se chama "hackear a recompensa" (reward hacking), e é uma preocupação séria à medida que os sistemas de IA ficam mais capazes. Criar recompensas que representem o que realmente queremos, e conferir como o sistema se comporta de fato, é uma parte importante de construir IA segura.
Outros desafios:
- Ele precisa de muita prática. O robô do labirinto precisou de centenas de tentativas para um labirinto minúsculo. Problemas reais podem levar milhões, o que é fácil numa simulação, mas lento e arriscado no mundo real. (Não dá para deixar um carro autônomo bater um milhão de vezes para aprender.)
- Simulações não são a realidade. Um robô que aprendeu num simulador perfeito pode tropeçar num piso de verdade, escorregadio.
- Explorar pode ser perigoso. Testar ações aleatórias tudo bem num jogo, não num hospital.
Um pequeno glossário
- Aprendizado por reforço: aprender o que fazer por tentativa e erro, guiado por recompensas e penalidades.
- Agente: quem aprende e faz as ações.
- Ambiente: o mundo onde o agente age.
- Ação: uma escolha que o agente faz.
- Recompensa: uma pontuação que diz ao agente o quanto um resultado foi bom.
- Política: a estratégia aprendida pelo agente, o que fazer em cada situação.
- Q-learning: um método clássico de aprendizado por reforço que estima o quanto cada ação é boa em cada situação.
- Explorar vs. aproveitar: testar coisas novas versus ficar com o que funcionou melhor até agora.
- RLHF: aprendizado por reforço com feedback humano, usado para deixar os chatbots mais úteis.
- Hackear a recompensa: quando o agente encontra um atalho não pretendido para conseguir uma recompensa alta.
Concluindo
Aprendizado por reforço é aprender fazendo: tentar algo, ver o que acontece e fazer mais do que dá certo. Só com recompensas e penalidades, ele consegue ensinar um robô a resolver um labirinto, um programa a vencer campeões mundiais e um chatbot a dar respostas que as pessoas realmente acham úteis.
A força dele está em descobrir estratégias que ninguém ensinou diretamente, e esse também é o risco: ele otimiza exatamente a recompensa que recebe. Assim como no adestramento de um cachorro, o segredo é recompensar a coisa certa.
Read next
O Que É Engenharia de Grafos? Como a IA Trabalha em Equipe para Fazer Coisas de Verdade
Um guia simples e sem jargões sobre engenharia de grafos, a ideia de 2026 de montar a IA como um mapa de etapas conectadas. Veja como os agentes de IA funcionam, por que pequenos erros se acumulam e como revisões e trabalho em equipe resolvem isso.
 nbkhope
O Que É Engenharia de Loops? Como Agentes de IA Trabalham Até Terminar o Serviço
Um guia simples e sem jargões sobre engenharia de loops, a ideia de 2026 de projetar o ciclo em que um agente de IA trabalha até terminar o serviço, com objetivos claros, feedback real, regras de parada e a hora de chamar uma pessoa.
nbkhope
O Que É Engenharia de Prompt? Como Pedir à IA Exatamente o Que Você Precisa
Um guia simples e sem jargões sobre engenharia de prompt, a habilidade de pedir aos chatbots de IA, como ChatGPT, Claude e Gemini, exatamente o que você precisa. Entenda o que torna um prompt bom e aprenda técnicas que qualquer pessoa pode usar.
nbkhope
Comentários
Be kind and specific. Comments with links from new accounts appear after a moderator reviews them.