O Que É Pré-treinamento? Como Modelos de IA Ganham Sua Formação Geral
Um guia simples e sem jargões sobre pré-treinamento, a enorme primeira etapa em que modelos de IA como o ChatGPT leem uma biblioteca gigante de textos e aprendem adivinhando a próxima palavra. Veja como funciona e por que custa tanto.

Nesta página
Antes de aprender a operar, um médico passa anos na escola aprendendo a ler, escrever, fazer contas e entender como o mundo funciona. Essa formação geral é a base de todo o resto.
Chatbots de IA como ChatGPT, Claude e Gemini passam por algo parecido. Antes de aprender a ser assistentes úteis, eles passam meses numa enorme primeira etapa de aprendizado chamada pré-treinamento (em inglês, pre-training). É nela que aprendem a linguagem, fatos e uma quantidade surpreendente de conhecimento geral, tudo jogando um único jogo simples, de novo e de novo.
Este artigo explica o pré-treinamento em linguagem simples: o que é, como funciona, o que um modelo aprende com ele e por que ele é tão caro.
O que é pré-treinamento?
Pré-treinamento é a primeira e maior etapa do treinamento de um modelo de IA. O modelo lê uma quantidade enorme de material geral, como textos de livros, sites e artigos, e aprende padrões amplos com ele. Só depois disso ele é treinado para um trabalho específico.
O "pré" quer dizer apenas antes: é o treinamento que acontece antes do treinamento especializado. Aliás, o "P" de GPT, como em ChatGPT, vem justamente de pré-treinado: Generative Pre-trained Transformer (Transformador Generativo Pré-treinado).
Veja como as etapas se comparam com a formação de uma pessoa:
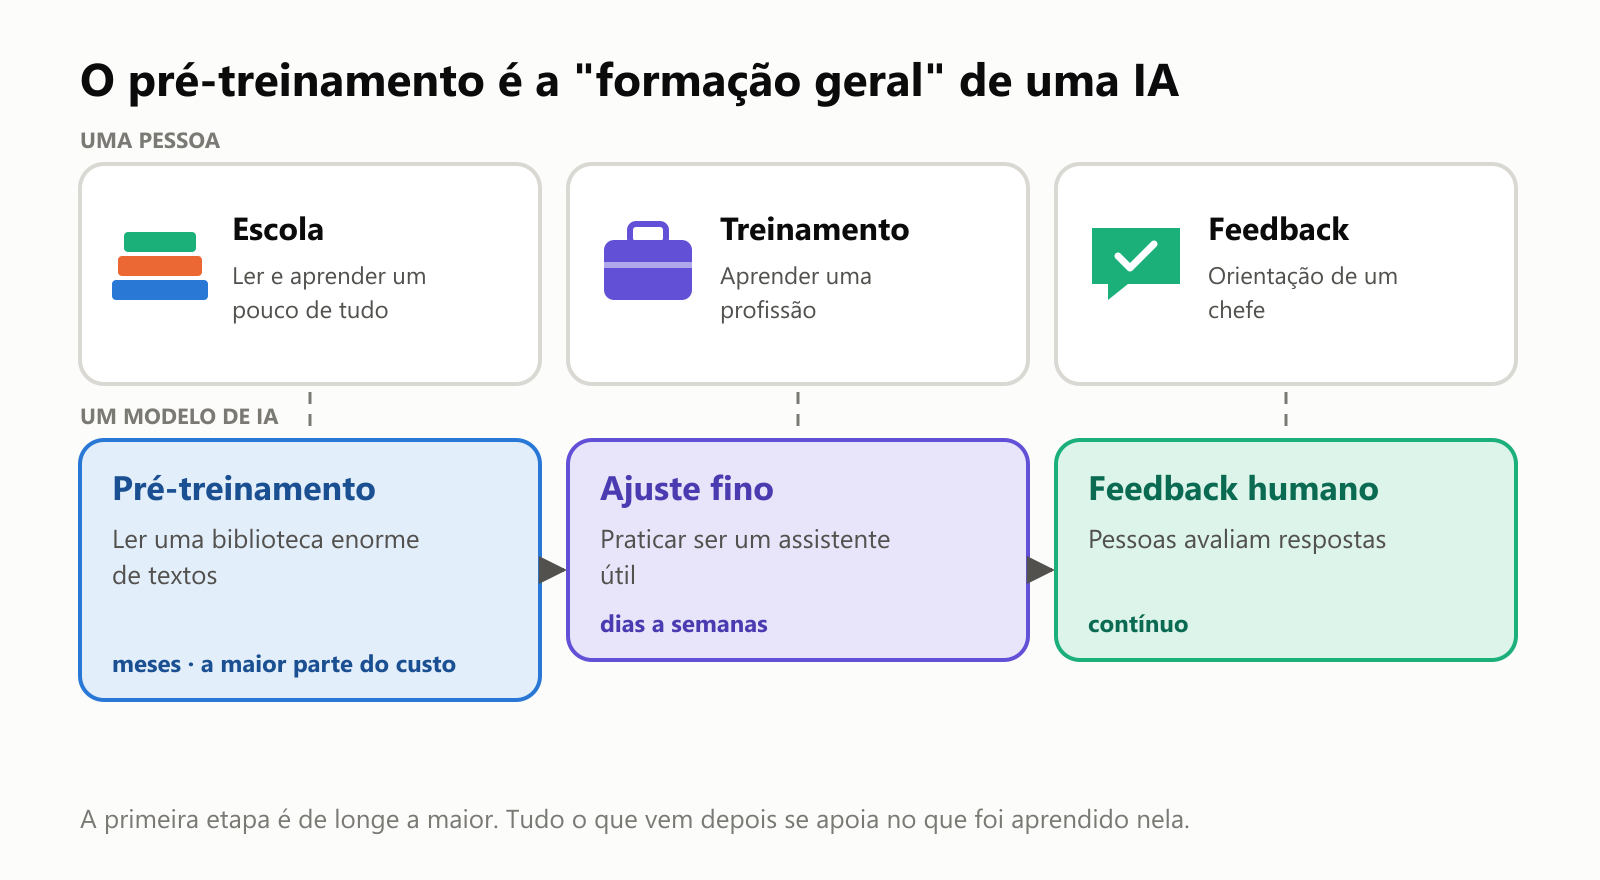
- Pré-treinamento: ler uma biblioteca enorme e aprender padrões gerais. Leva meses e consome a maior parte do dinheiro.
- Ajuste fino (fine-tuning): praticar com exemplos menores e cuidadosamente escolhidos de um trabalho específico, como responder perguntas de forma útil.
- Feedback humano: pessoas avaliam ou comparam as respostas do modelo, e ele é ajustado para dar o tipo de resposta que as pessoas preferem.
O único jogo simples: adivinhar a próxima palavra
Então, como um modelo "lê" e aprende? Ele joga um jogo de adivinhação. Mostre um texto, esconda o que vem depois e peça para ele adivinhar a próxima palavra. Depois revele a resposta e ajuste o modelo um pouquinho, para ele chutar um pouco melhor da próxima vez.
A parte esperta é que cada frase vira várias perguntas de treino:
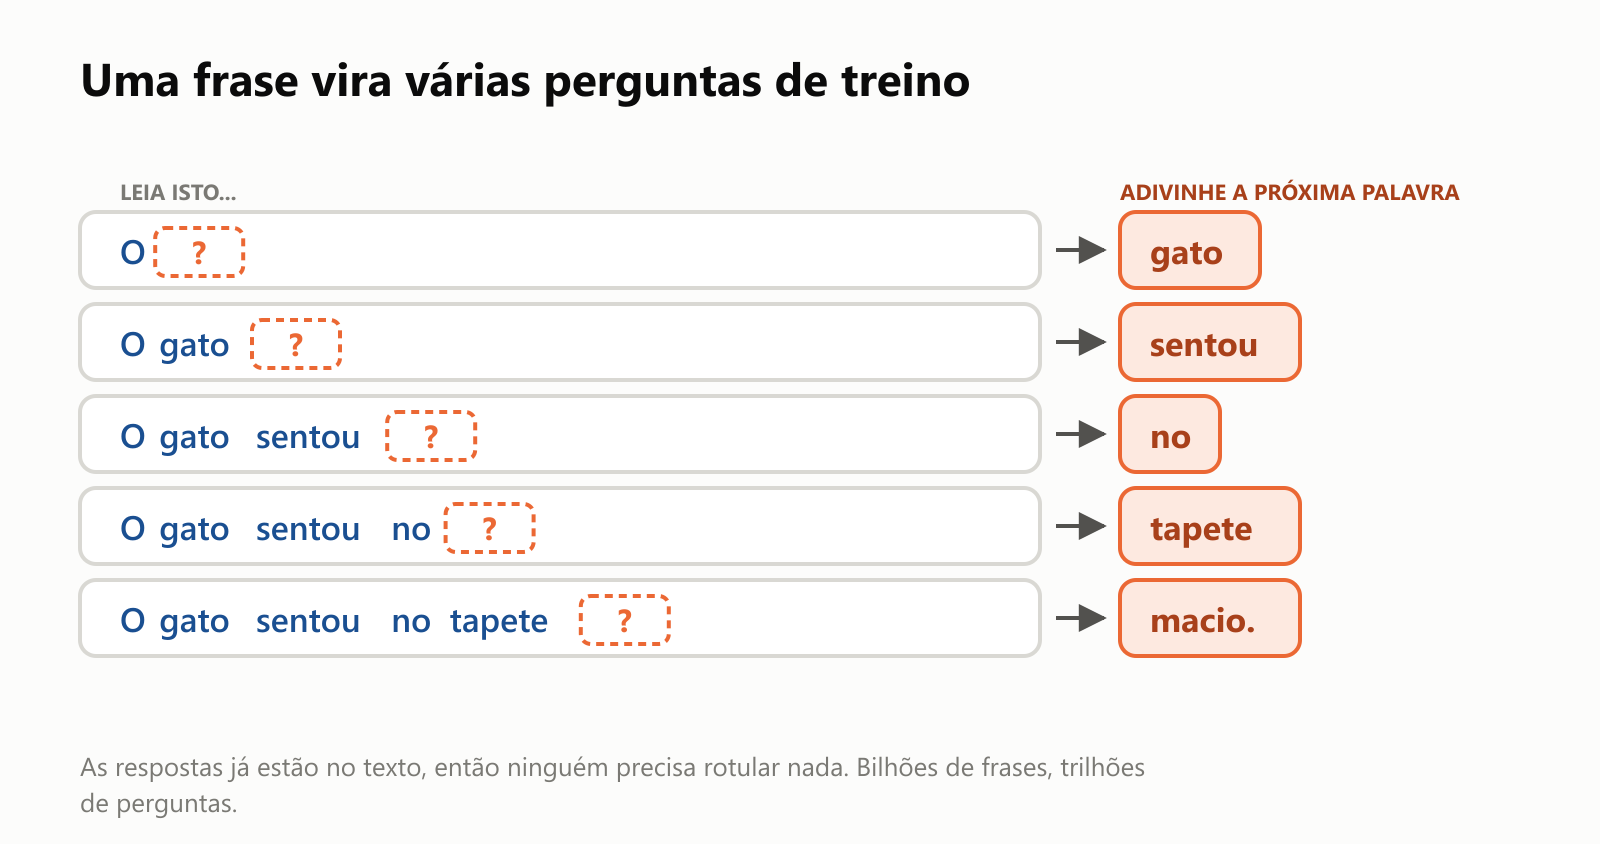
Repare em algo importante: ninguém precisou rotular nada. A resposta certa, a próxima palavra, já está no próprio texto. Por isso isso se chama aprendizado autossupervisionado: os dados supervisionam a si mesmos. Compare com o trabalho humano cuidadoso descrito em O Que É Rotulagem de Dados?. Como não precisa de rótulos, o modelo pode aprender com quantidades praticamente ilimitadas de texto.
(Para ser exato, os modelos trabalham com tokens, que são palavras ou pedaços de palavras, e não palavras inteiras. Mas "adivinhar a próxima palavra" é um bom jeito de imaginar.)
O que um modelo aprende com um jogo tão simples
Adivinhar a próxima palavra parece quase bobo. Mas, para acertar em trilhões de exemplos, o modelo precisa aprender muito mais do que vocabulário:
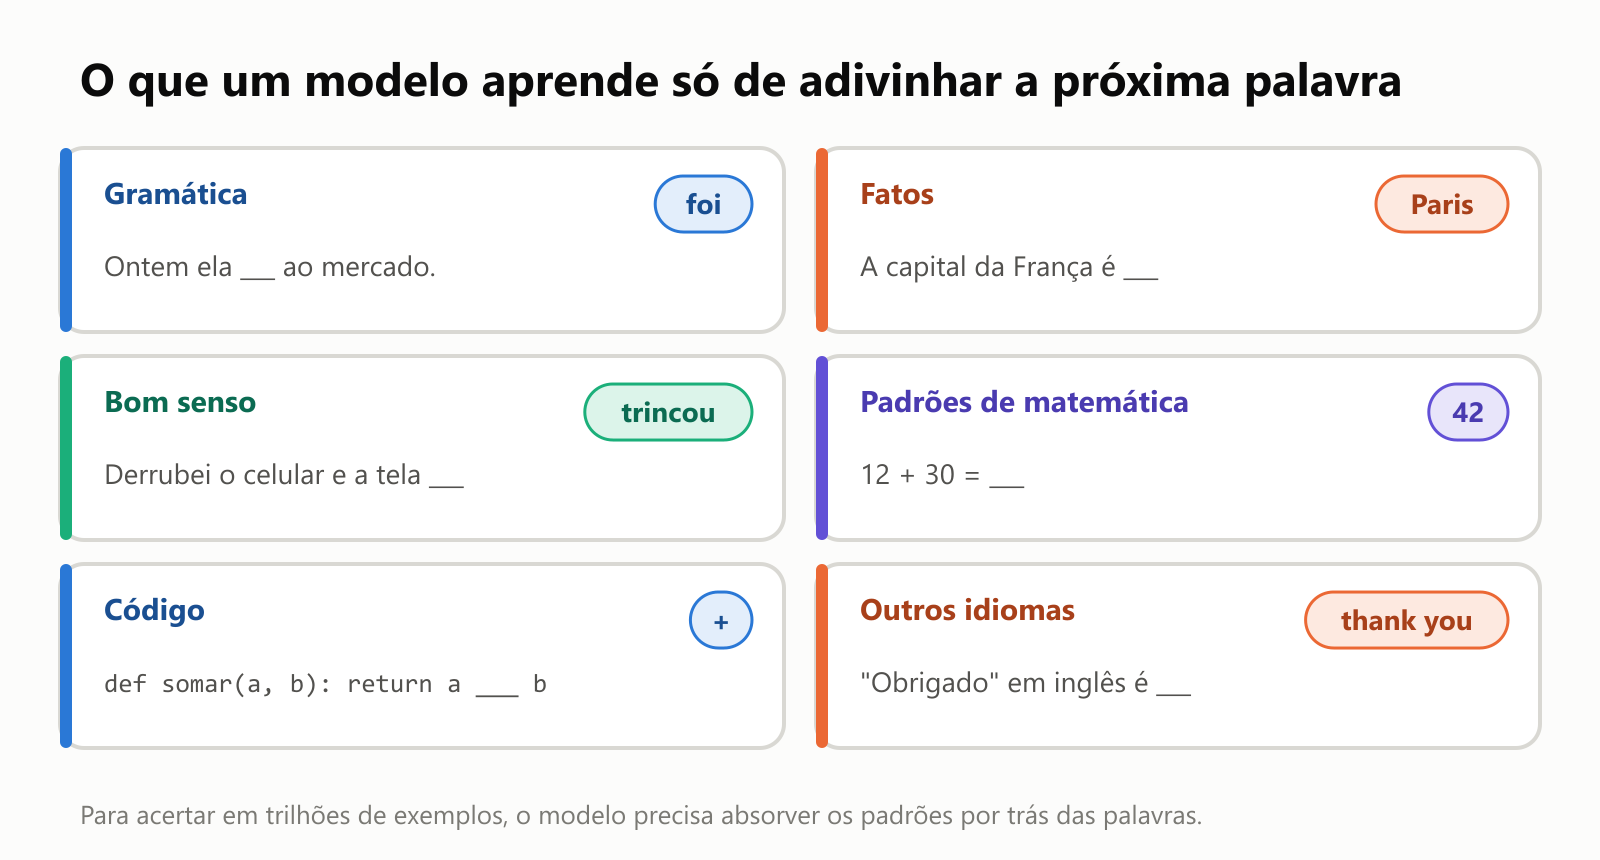
Para prever "foi", ele precisa aprender gramática. Para prever "Paris", precisa absorver fatos. Para prever "trincou", precisa absorver um pouco de bom senso sobre como o mundo funciona. Lendo bastante código de computador, começa a aprender programação. Lendo bastante texto em idiomas diferentes, aprende a traduzir.
Nenhuma dessas habilidades é ensinada diretamente. Elas surgem porque ajudam no único objetivo: adivinhar bem a próxima palavra.
Uma biblioteca realmente gigantesca
O pré-treinamento precisa de uma quantidade de texto de dar nó na cabeça. Normalmente ela vem de uma mistura de:
- Páginas da web, muitas vezes de enormes arquivos públicos da internet.
- Livros e enciclopédias, como a Wikipédia.
- Código de computador de projetos públicos.
- Artigos científicos, notícias, fóruns e muito mais.
Antes do treino, esse texto passa por uma limpeza: duplicatas são removidas, spam e páginas de baixa qualidade são filtrados, e conteúdo nocivo ou privado é reduzido o máximo possível.
E a quantidade não para de crescer:
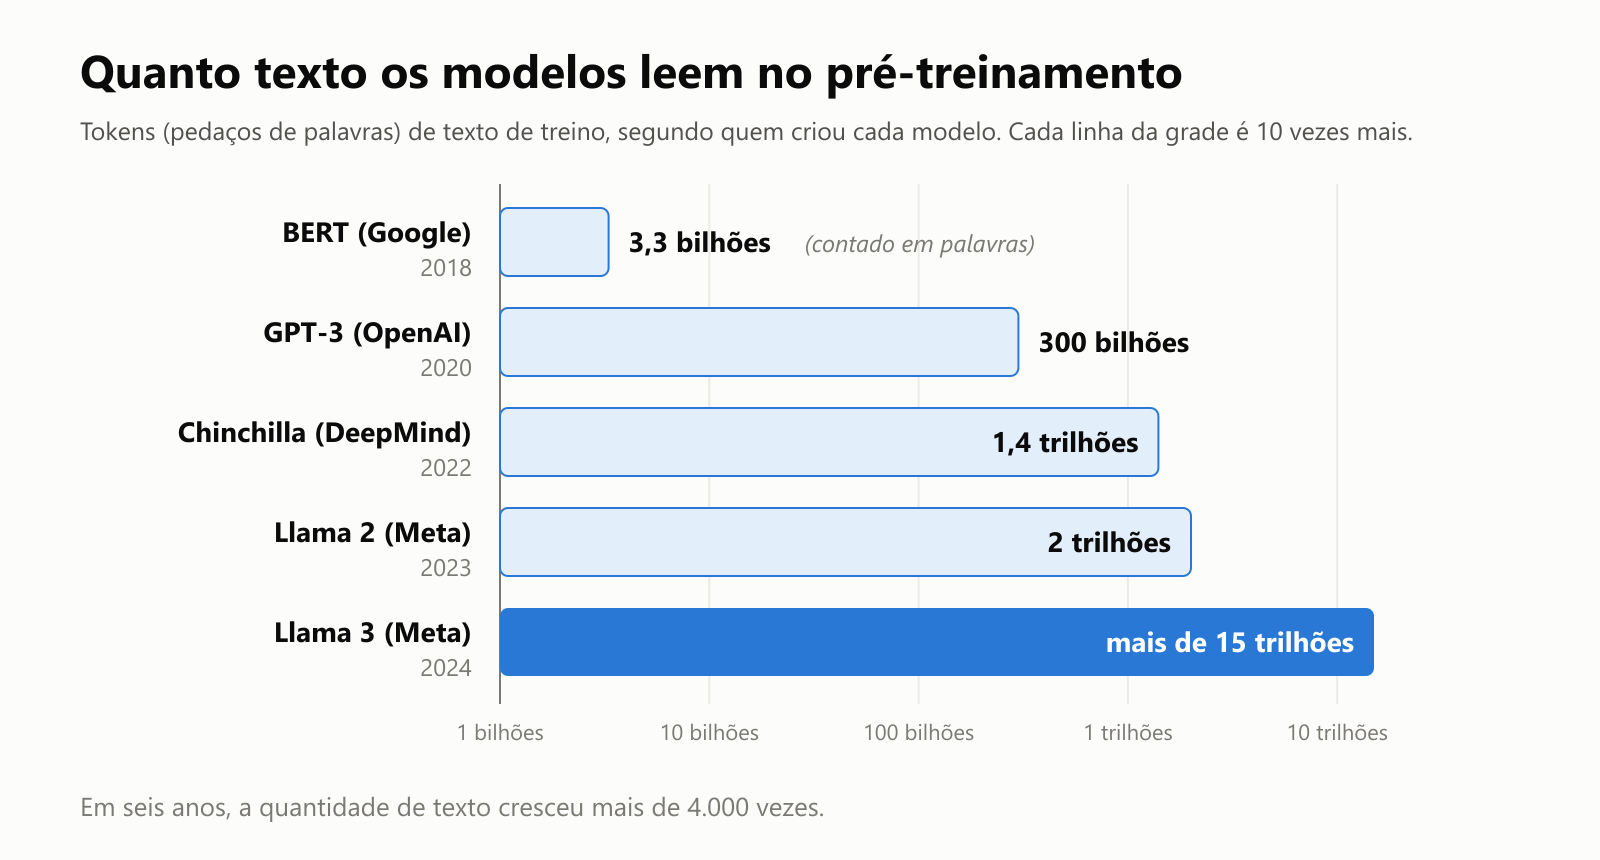
Em só seis anos, a quantidade de texto cresceu mais de 4.000 vezes. Quanta leitura são 15 trilhões de tokens? Vamos comparar com uma leitora humana muito dedicada:
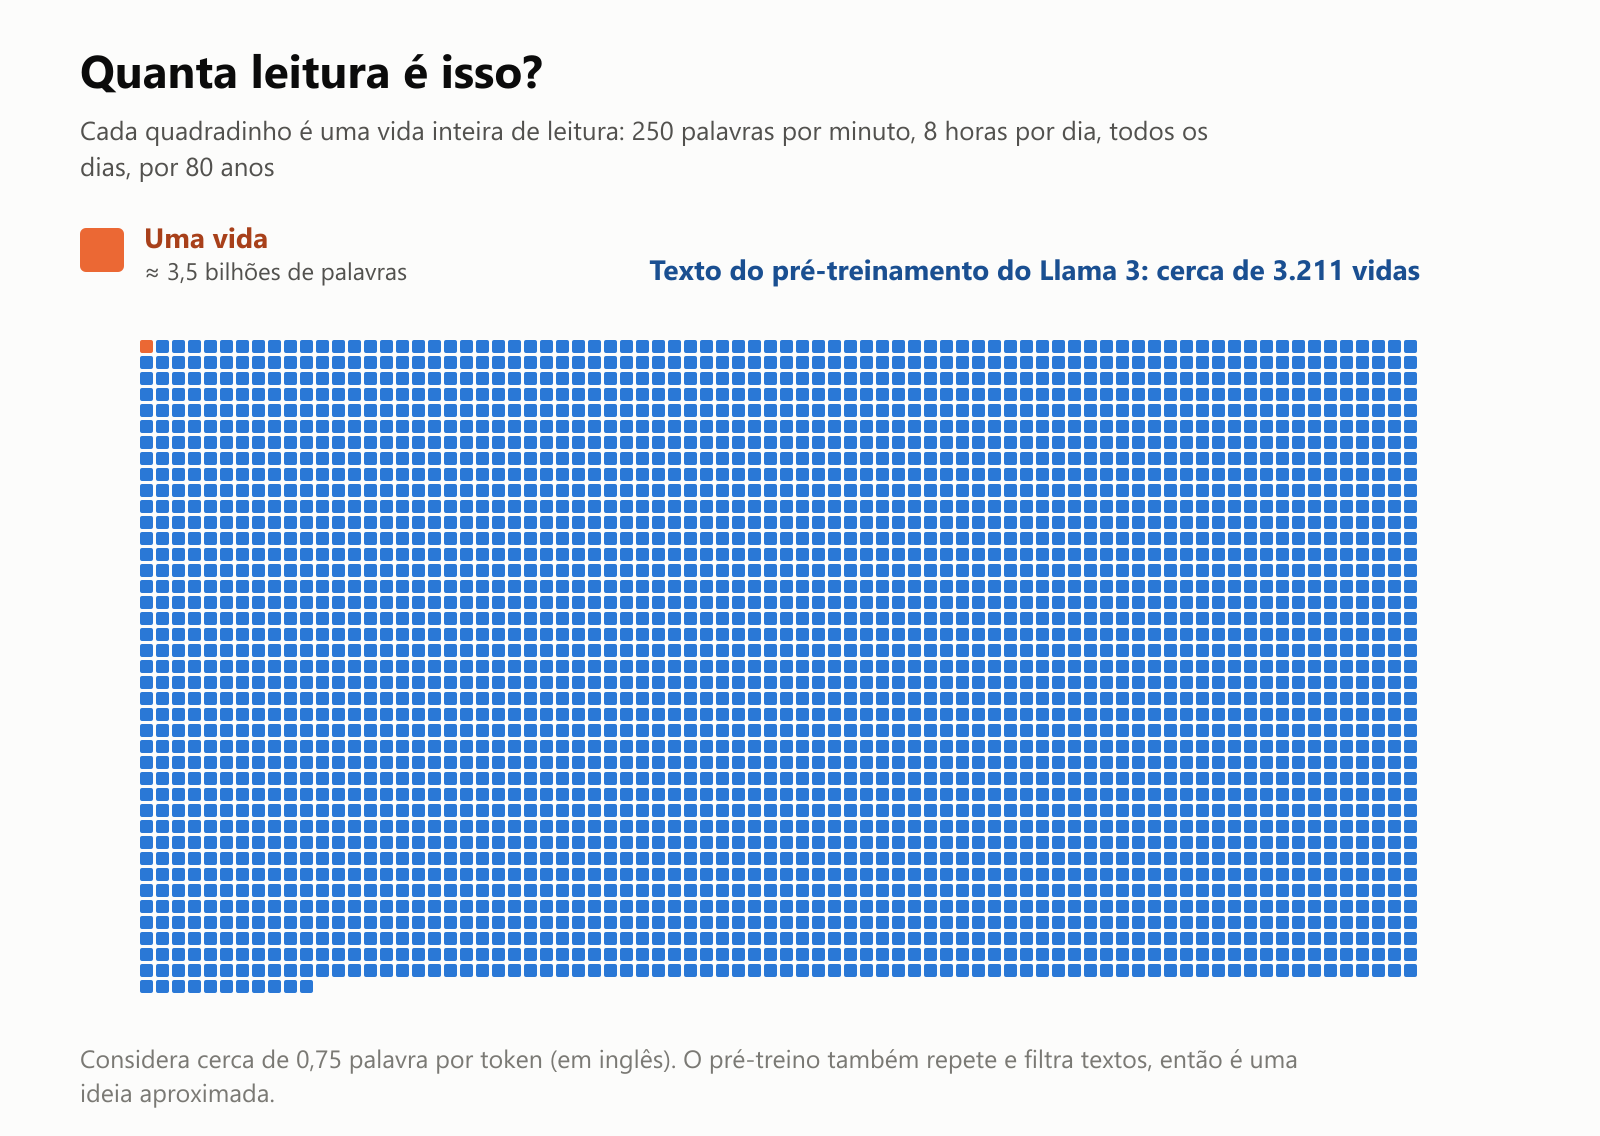
Alguém lendo 8 horas por dia, todos os dias, durante 80 anos, leria cerca de 3,5 bilhões de palavras. O texto do pré-treinamento do Llama 3 equivale a umas 3.200 dessas vidas. Dito de outro jeito, uma pessoa precisaria de cerca de 250 mil anos de leitura em tempo integral para dar conta. (É uma comparação aproximada, considerando uns três quartos de palavra por token, em inglês.)
Por que o pré-treinamento custa tanto
Ler todo esse texto não é só questão de armazenamento. Para cada token, o modelo faz um palpite, confere e ajusta seus bilhões de configurações internas. Isso exige:
- Milhares de chips especializados (GPUs) trabalhando juntos, muitas vezes por meses.
- Muita energia elétrica para fazê-los funcionar e resfriá-los.
- Equipes de especialistas para coletar e limpar os dados e manter o treino funcionando.
Estima-se que as maiores rodadas de pré-treinamento de hoje custem dezenas ou até centenas de milhões de dólares. O presidente da OpenAI, Sam Altman, disse em 2023 que treinar o GPT-4 custou mais de 100 milhões de dólares. Por isso, só um punhado de empresas e laboratórios de pesquisa pré-treina os maiores modelos do zero.
Maior, porém, não é automaticamente melhor. Em 2022, a pesquisa Chinchilla, da DeepMind, descobriu que muitos modelos grandes tinham sido treinados com pouco texto para o tamanho deles, e que um modelo menor treinado com mais dados podia superar um maior. Acertar esse equilíbrio economiza muito dinheiro.
O que um modelo pré-treinado consegue e não consegue fazer
Depois do pré-treinamento, você tem o que se chama de modelo base (ou modelo de fundação). Ele sabe muita coisa, mas ainda não é um assistente. Ele só continua textos.
Pergunte a um modelo base "Qual é a capital da França?" e ele pode responder "Qual é a capital da Alemanha? Qual é a capital da Espanha?", porque na internet perguntas assim costumam aparecer em listas de questões de quiz. Ele não está sendo difícil: está fazendo exatamente o que aprendeu, que é continuar o texto de um jeito provável.
Por isso o ajuste fino e o feedback humano vêm em seguida: eles ensinam o modelo a seguir instruções, responder de forma útil e evitar respostas nocivas. Mas quase todo o conhecimento e a habilidade com a linguagem do modelo vêm do pré-treinamento.
Outras coisas que vale saber:
- Data de corte do conhecimento: um modelo só conhece o mundo até a época em que os textos do pré-treinamento foram coletados. Pergunte sobre acontecimentos posteriores, e ele pode não saber, ou pode chutar.
- Ele aprende o ruim junto com o bom: a internet tem erros, mitos e preconceitos, e um modelo pode absorver isso também. As etapas seguintes e a filtragem tentam reduzir o problema, mas é um desafio contínuo.
- Não é só para chatbots: o pré-treinamento é usado em toda a IA. Modelos de visão muitas vezes são pré-treinados com milhões de fotos e depois ajustados para, por exemplo, encontrar problemas em raios-X. Essa ideia de "aprender coisas gerais primeiro e depois se especializar" se chama aprendizado por transferência.
Um pequeno glossário
- Pré-treinamento: a primeira e maior etapa do treinamento, em que um modelo aprende padrões gerais com uma quantidade enorme de dados.
- Ajuste fino (fine-tuning): treino adicional com um conjunto menor e focado de exemplos, para especializar o modelo.
- Feedback humano: pessoas avaliando ou comparando respostas para guiar o modelo a respostas melhores.
- Modelo base (ou de fundação): o modelo depois do pré-treinamento, antes de virar um assistente.
- Aprendizado autossupervisionado: aprendizado em que os próprios dados trazem as respostas, como adivinhar a próxima palavra.
- Token: uma palavra ou pedaço de palavra, a unidade que os modelos leem e escrevem.
- Data de corte do conhecimento: o momento a partir do qual os dados de treino do modelo não têm mais informações.
- Aprendizado por transferência: reaproveitar o que um modelo aprendeu de forma geral numa tarefa nova e específica.
- GPT: Generative Pre-trained Transformer, o tipo de modelo por trás do ChatGPT.
Concluindo
O pré-treinamento é a formação geral de um modelo de IA. Jogando um único jogo simples, adivinhar a próxima palavra, ao longo de uma biblioteca do tamanho de milhares de vidas humanas de leitura, o modelo absorve gramática, fatos, bom senso, código e muito mais. É lento, caríssimo e só poucas organizações conseguem fazê-lo na maior escala, mas é a base sobre a qual tudo o mais é construído.
Então, quando um chatbot de IA explicar uma receita, traduzir uma frase ou ajudar a corrigir um bug, lembre-se de que o assistente prestativo que você vê foi construído sobre meses de leitura por baixo.
Read next
O Que É Aprendizado por Reforço? Como a IA Aprende com Tentativa, Erro e Recompensa
Uma introdução simples e sem jargões ao aprendizado por reforço, o jeito como a IA aprende com tentativa, erro e recompensa, como um cachorro aprendendo com petiscos. Veja um robô aprender um labirinto e como isso molda os chatbots.
 nbkhope
O Que É Engenharia de Grafos? Como a IA Trabalha em Equipe para Fazer Coisas de Verdade
Um guia simples e sem jargões sobre engenharia de grafos, a ideia de 2026 de montar a IA como um mapa de etapas conectadas. Veja como os agentes de IA funcionam, por que pequenos erros se acumulam e como revisões e trabalho em equipe resolvem isso.
nbkhope
O Que É Engenharia de Loops? Como Agentes de IA Trabalham Até Terminar o Serviço
Um guia simples e sem jargões sobre engenharia de loops, a ideia de 2026 de projetar o ciclo em que um agente de IA trabalha até terminar o serviço, com objetivos claros, feedback real, regras de parada e a hora de chamar uma pessoa.
nbkhope
Comentários
Be kind and specific. Comments with links from new accounts appear after a moderator reviews them.