O Que É um Transformer na IA? A Ideia por Trás do ChatGPT, Explicada de Forma Simples
Um guia simples e sem jargões sobre os transformers, a arquitetura de IA por trás do ChatGPT, do Claude e do Gemini. Entenda como a "atenção" ajuda a IA a entender palavras no contexto e por que isso mudou a IA tão rápido.

Nesta página
ChatGPT, Claude, Gemini, a IA que traduz suas mensagens, a que gera legendas para vídeos: quase toda a IA que vira notícia hoje tem uma coisa em comum. Por baixo dos panos, todas são construídas com a mesma arquitetura, chamada transformer.
Está até no nome: o "T" de ChatGPT vem de transformer (Generative Pre-trained Transformer, ou Transformador Generativo Pré-treinado). E não, não tem nada a ver com robôs que viram carros.
Este artigo explica o que é um transformer em linguagem simples: o problema que ele resolveu, a sua grande ideia (chamada atenção), o que acontece lá dentro e por que ele dominou a IA em poucos anos.
O problema: ler uma palavra de cada vez
A linguagem é complicada porque o sentido depende do contexto. "Banco" quer dizer uma coisa em "sentei no banco da praça" e outra em "fui ao banco pagar uma conta". Para entender uma palavra, muitas vezes é preciso olhar para outras palavras, às vezes bem distantes na frase.
Antes de 2017, a maior parte das IAs lia texto como quem espia pelo buraco da fechadura: uma palavra de cada vez, da esquerda para a direita, levando um resumo do que veio antes. Esses modelos (chamados redes neurais recorrentes) tinham dois grandes problemas:
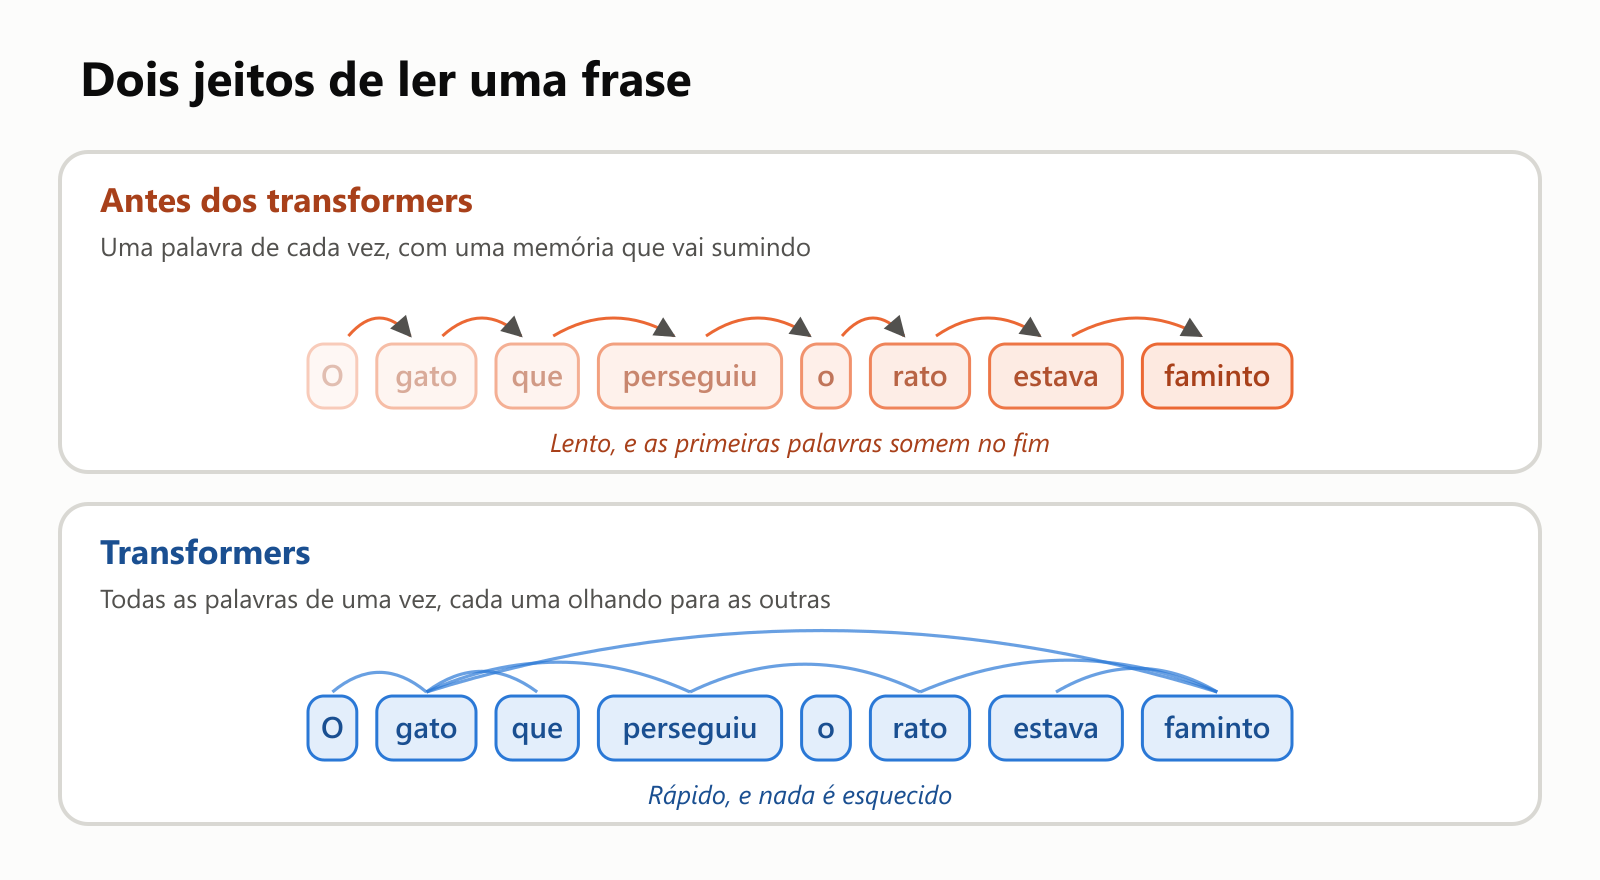
- Eles esqueciam. No fim de uma frase longa, as primeiras palavras já tinham se apagado. Em "O gato que perseguiu o rato estava faminto", o modelo podia perder o fio de quem estava com fome.
- Eles eram lentos. Cada palavra precisava esperar a anterior, então o trabalho não podia ser dividido e feito em paralelo. Isso dificultava treiná-los com quantidades realmente grandes de texto.
A grande ideia: atenção
Em 2017, oito pesquisadores do Google publicaram um artigo com um título que ficou famoso: "Attention Is All You Need" ("Atenção é tudo de que você precisa"). Eles apresentaram o transformer, criado originalmente para traduzir entre idiomas, e o ingrediente principal era a atenção.
A atenção é uma ideia simples: quando a IA processa uma palavra, ela olha para todas as outras palavras do texto e decide quais importam mais para entendê-la. Depois, ela mistura informações dessas palavras.
Veja um exemplo. A quem "ele" se refere nestas duas frases?
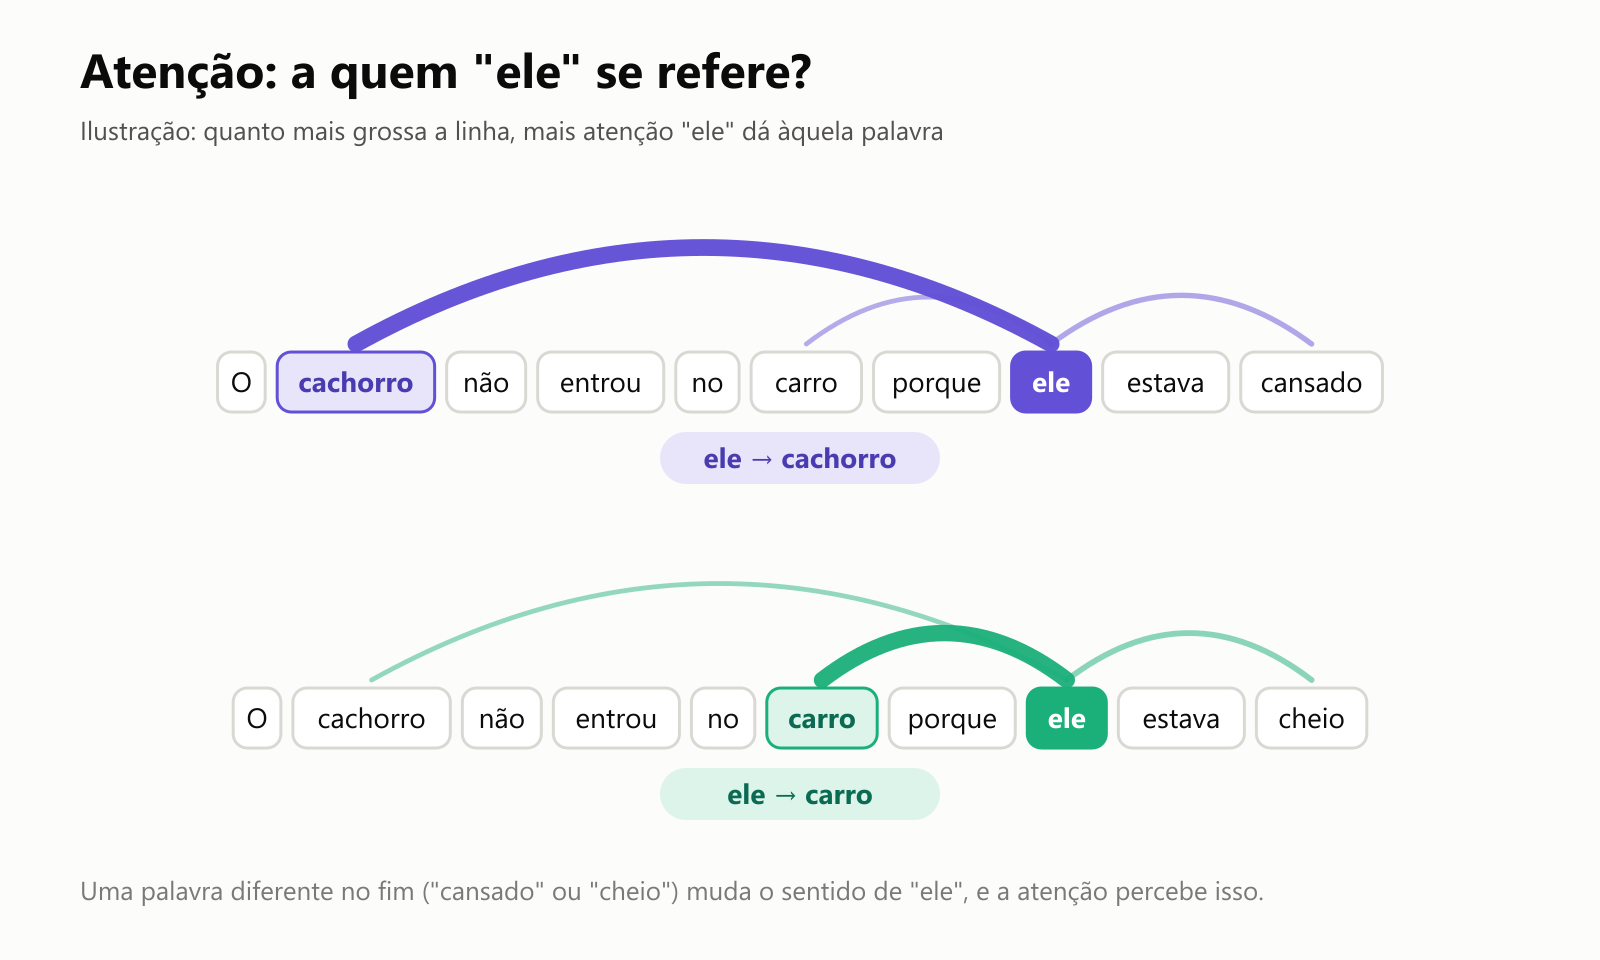
Você sabe na hora que um "ele" cansado é o cachorro, e um "ele" cheio é o carro. Trocar uma palavra no fim muda o sentido. A atenção permite que um transformer faça a mesma ligação: ao processar "ele", dá mais peso a "cachorro" numa frase e a "carro" na outra.
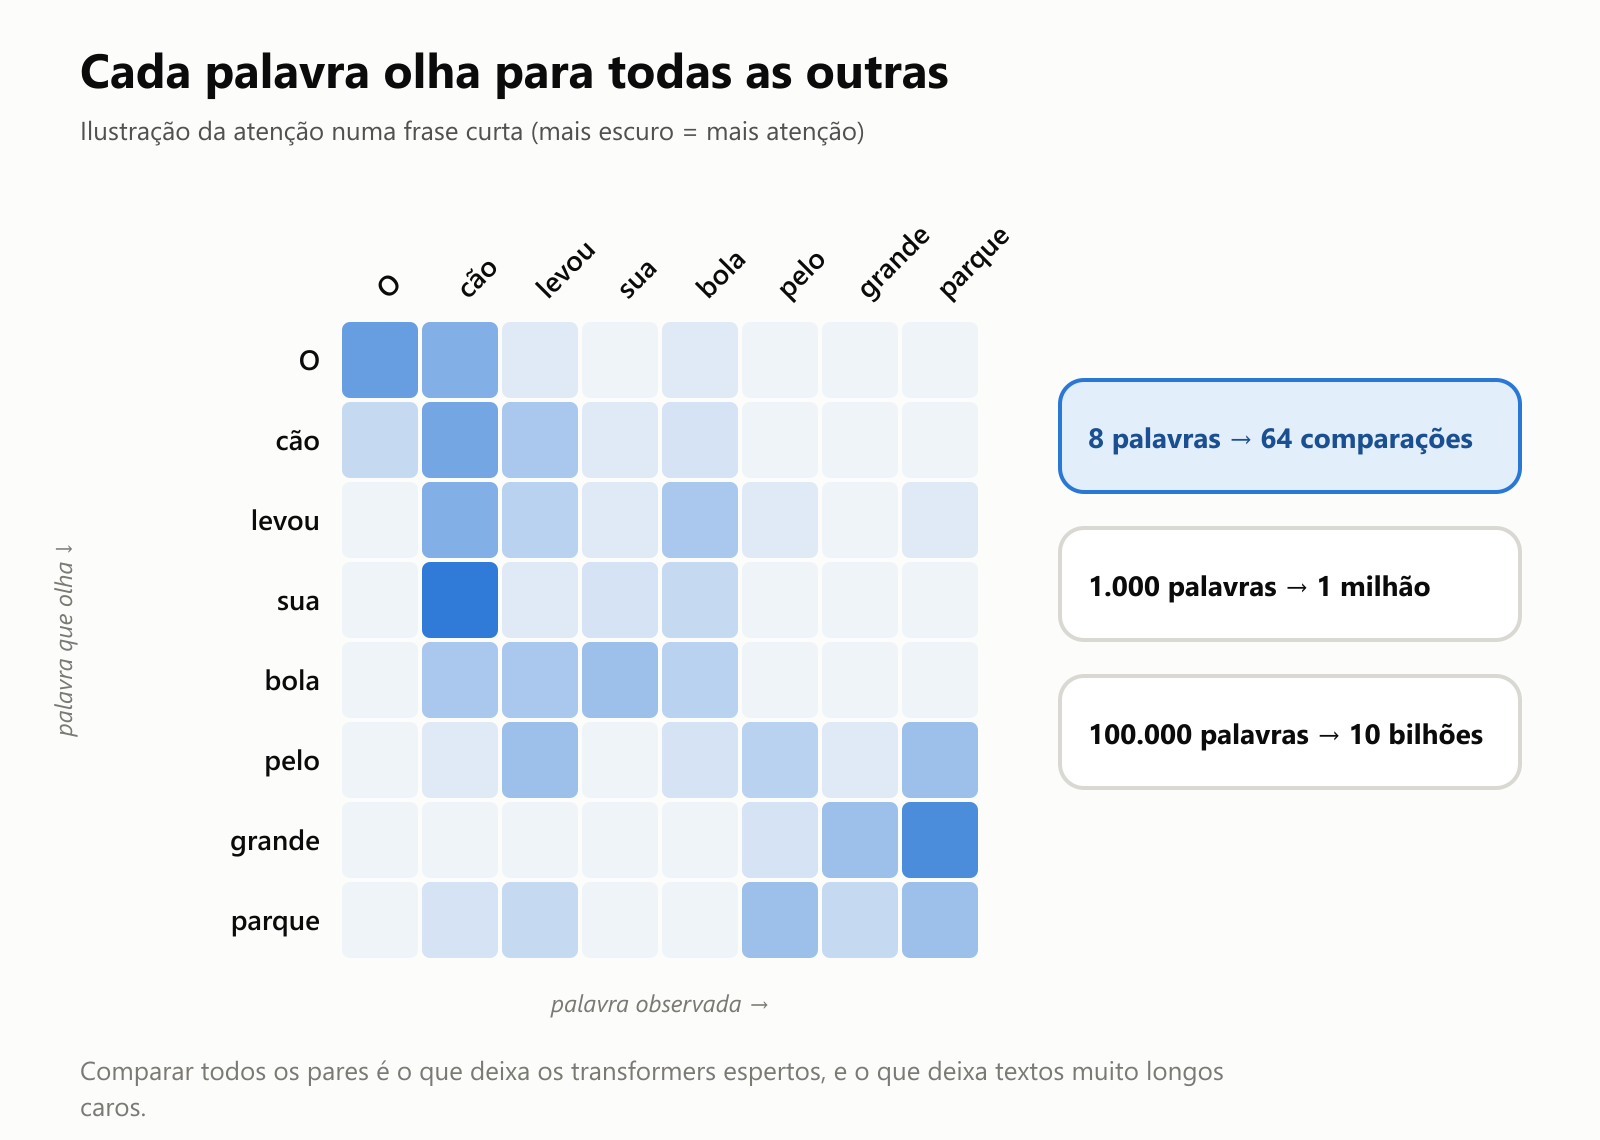
O detalhe crucial é que a atenção funciona com todas as palavras de uma vez. Cada palavra olha para todas as outras ao mesmo tempo, não importa a distância entre elas:
Isso resolveu os dois problemas antigos de uma vez:
- Nada é esquecido: uma palavra no fim pode olhar direto para uma palavra no começo.
- É rápido: todas essas comparações podem acontecer em paralelo em chips gráficos (GPUs), então os transformers podem ser treinados com quantidades enormes de texto.
O que acontece dentro de um transformer
Este é o caminho de um texto dentro de um transformer, de forma simplificada:
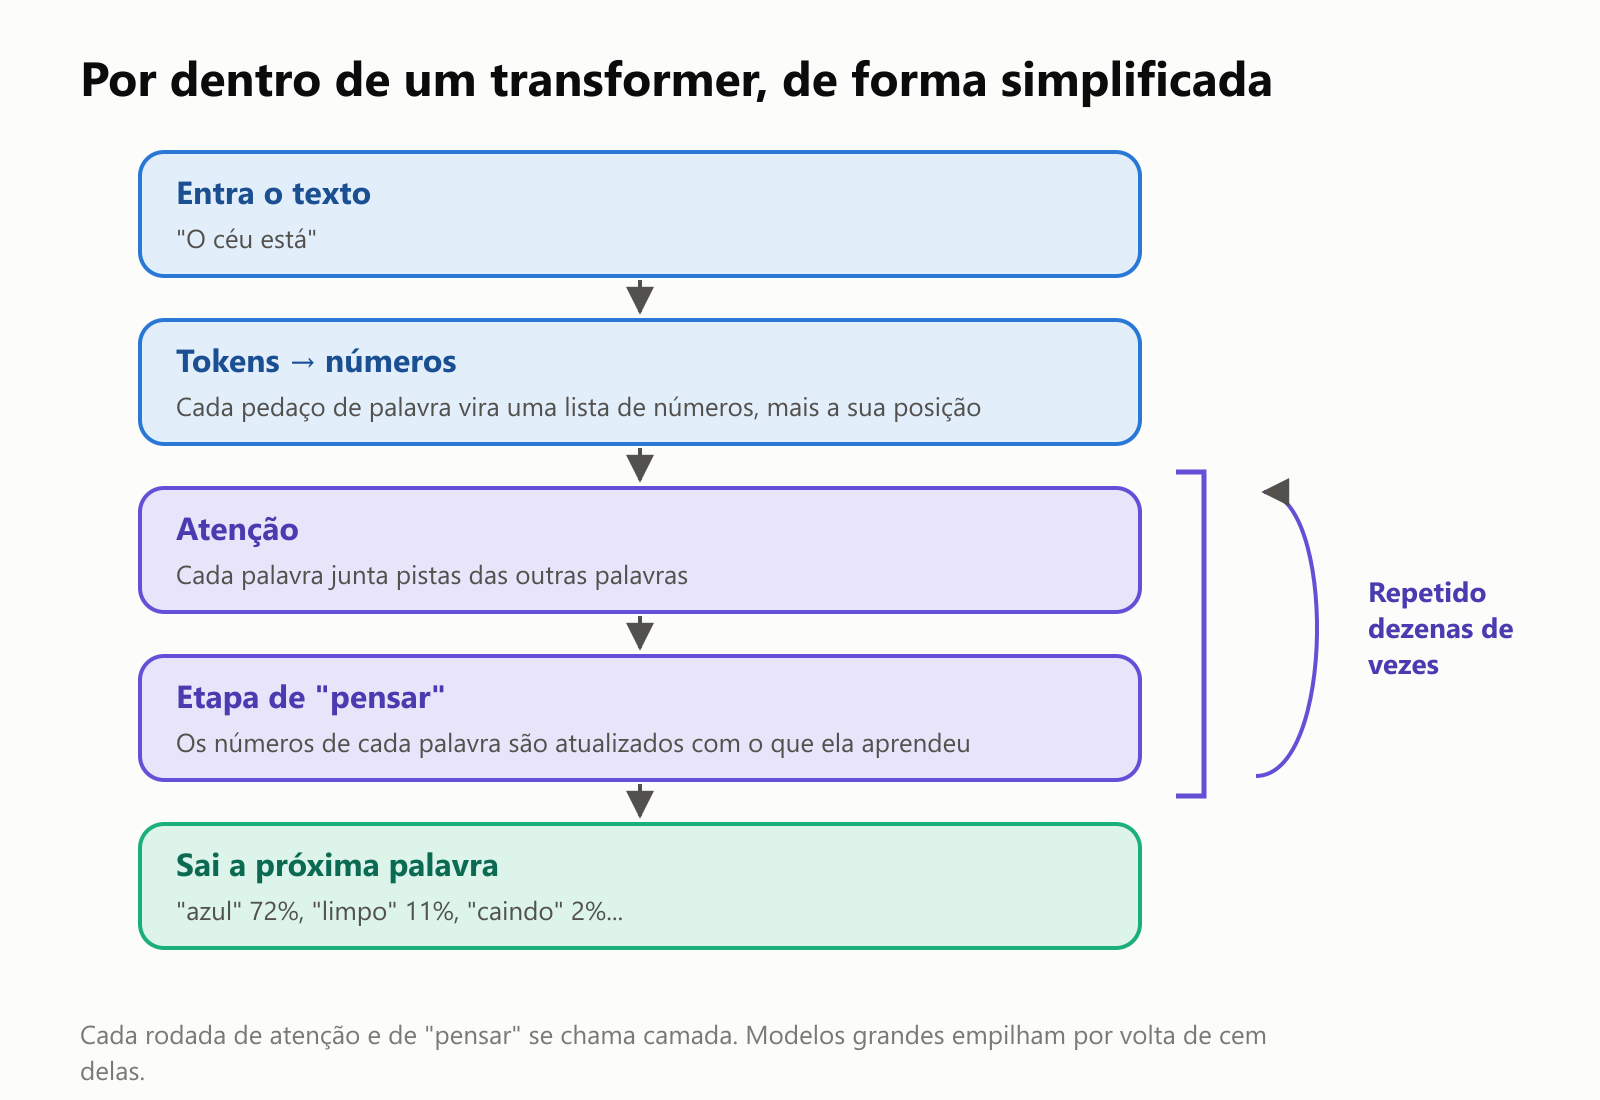
- Entra o texto. Por exemplo: "O céu está".
- Tokens viram números. O texto é dividido em tokens (palavras ou pedaços de palavras), e cada um vira uma longa lista de números que representa o seu significado. O modelo também acrescenta informações sobre a posição de cada token, porque a atenção sozinha não sabe a ordem das palavras.
- Atenção. Cada token junta informações dos outros, como vimos acima.
- Etapa de "pensar". Os números de cada token são atualizados com o que ele aprendeu, por uma pequena rede neural.
- Repetir. As etapas 3 e 4 formam uma camada, e os modelos grandes empilham dezenas delas, muitas vezes por volta de cem. As primeiras camadas captam coisas simples, como gramática; as últimas captam significados mais abstratos.
- Sai a próxima palavra. Num chatbot, a etapa final produz uma lista de próximas palavras prováveis. O modelo escolhe uma, acrescenta ao texto e roda de novo para produzir a próxima palavra, e a seguinte.
Por que os transformers dominaram
Como os transformers aprendem de forma tão eficiente com quantidades enormes de dados, os pesquisadores puderam deixá-los muito, muito maiores, e maior acabou significando melhor:
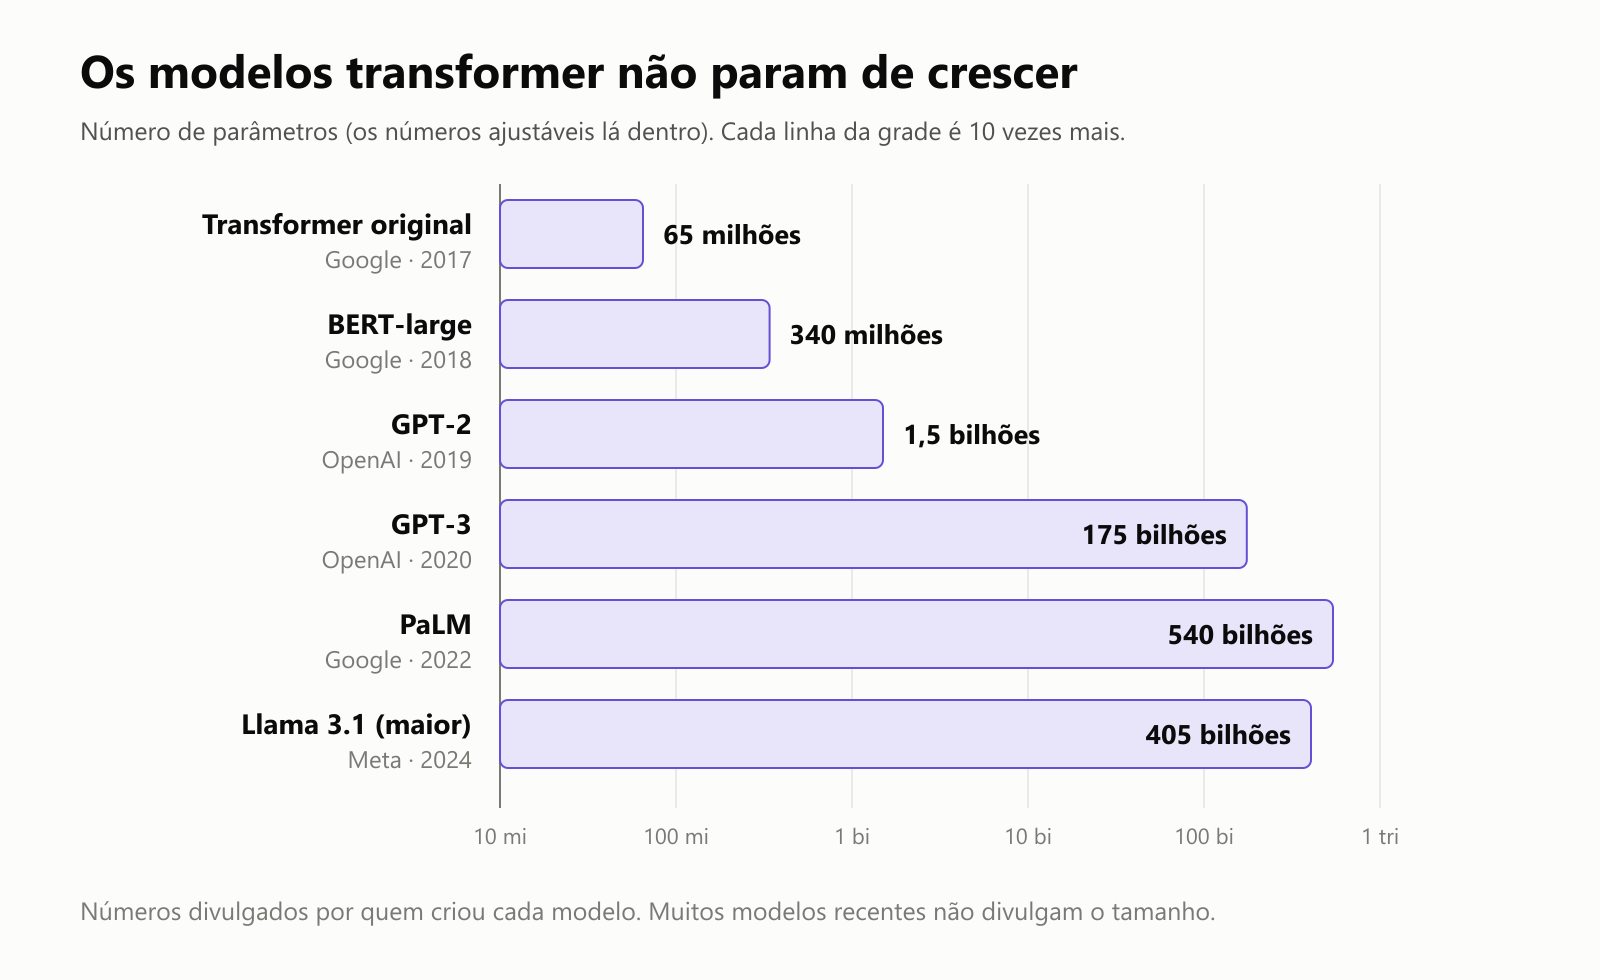
Parâmetros são os números ajustáveis dentro de um modelo, regulados durante o treinamento. Em cinco anos, os maiores modelos cresceram cerca de 10.000 vezes. (Muitos dos melhores modelos atuais não divulgam o tamanho, então os gigantes mais novos não aparecem neste gráfico.)
Eles também aprenderam a ler textos bem mais longos de uma vez. A quantidade de texto que um modelo consegue considerar ao mesmo tempo se chama janela de contexto:
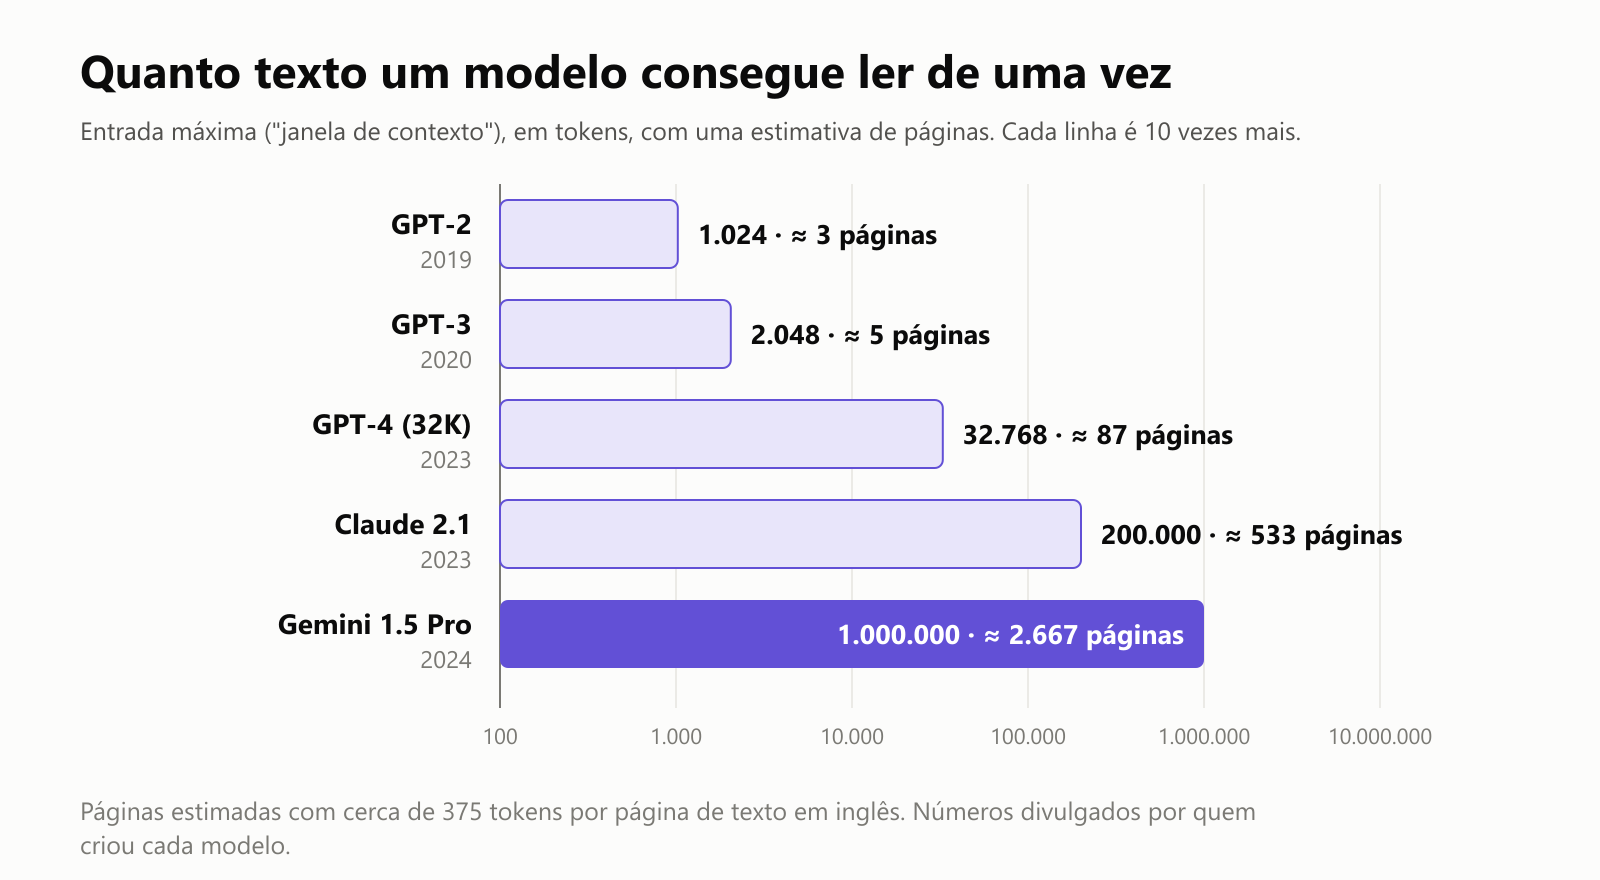
De algumas páginas para milhares de páginas em uns cinco anos. É por isso que hoje dá para entregar a um chatbot um relatório, um contrato ou um livro inteiro e fazer perguntas sobre ele.
O artigo "Attention Is All You Need" se tornou um dos mais citados da ciência da computação moderna, e as ideias dele se espalharam muito além dos chatbots.
Não é só para palavras
Qualquer coisa que possa ser dividida em pedaços pode alimentar um transformer:
- Imagens: os Vision Transformers (2020) cortam uma imagem em pequenos quadradinhos e os tratam como palavras, deixando cada pedaço "prestar atenção" nos outros.
- Fala: sistemas de reconhecimento de voz como o Whisper, da OpenAI, usam transformers para transformar áudio em texto.
- Ciência: o AlphaFold 2, da DeepMind, que prevê o formato 3D de proteínas, usa muito a atenção.
- Código, música, vídeo: assistentes de programação, geradores de música e geradores de vídeo também costumam ser feitos com transformers.
Os limites dos transformers
Os transformers são poderosos, mas não são perfeitos:
- Textos longos são caros. Lembre-se de que cada palavra olha para todas as outras. Dobre o tamanho do texto, e o número de comparações aumenta umas quatro vezes. É por isso que janelas de contexto enormes exigem engenharia esperta e muito poder de computação.
- Eles são famintos. Treinar um transformer grande exige quantidades enormes de dados, energia e dinheiro.
- Eles não "entendem" de verdade como as pessoas. A atenção encontra padrões em como as palavras se relacionam. Isso é impressionante, mas os transformers ainda podem errar com toda a confiança (as chamadas alucinações).
- Eles são difíceis de explicar. Com bilhões de números e dezenas de camadas, é difícil dizer exatamente por que um transformer deu uma certa resposta. Pesquisadores trabalham em jeitos de olhar lá dentro.
Pesquisadores também estão explorando alternativas e complementos que lidam com textos longos de forma mais barata, mas, por enquanto, os transformers continuam sendo a base da maior parte da IA de ponta.
Um pequeno glossário
- Transformer: uma arquitetura de rede neural, apresentada em 2017, que processa todas as palavras de uma vez usando atenção.
- Atenção: um jeito de cada palavra olhar para todas as outras e decidir quais importam mais para entendê-la.
- Cabeça de atenção: um dos vários "holofotes" de atenção trabalhando em paralelo, cada um focando em relações diferentes.
- Token: uma palavra ou pedaço de palavra, a unidade que um transformer lê e escreve.
- Informação de posição: números extras que dizem ao modelo onde cada token está no texto.
- Camada: uma rodada de atenção mais uma etapa de "pensar". Modelos grandes empilham dezenas.
- Parâmetros: os números ajustáveis dentro de um modelo, regulados durante o treinamento.
- Janela de contexto: quanto texto um modelo consegue considerar de uma vez.
- GPT: Generative Pre-trained Transformer, a família de modelos por trás do ChatGPT.
- Rede neural recorrente (RNN): uma arquitetura mais antiga, que lia o texto uma palavra de cada vez.
Concluindo
Um transformer é a arquitetura por trás de quase toda a IA de ponta de hoje. A sua grande ideia, a atenção, permite que cada palavra olhe para todas as outras de uma vez e decida o que importa, assim como você sabe na hora se "ele" é o cachorro ou o carro. Isso deixou a IA mais esperta com o contexto e muito mais rápida de treinar, o que permitiu aos pesquisadores aumentar os modelos de forma impressionante.
Então, da próxima vez que você conversar com uma IA, traduzir uma mensagem ou ver uma legenda automática, vai saber o que está trabalhando nos bastidores: camada após camada de palavras prestando atenção umas nas outras.
Read next
O Que É Aprendizado por Reforço? Como a IA Aprende com Tentativa, Erro e Recompensa
Uma introdução simples e sem jargões ao aprendizado por reforço, o jeito como a IA aprende com tentativa, erro e recompensa, como um cachorro aprendendo com petiscos. Veja um robô aprender um labirinto e como isso molda os chatbots.
 nbkhope
O Que É Engenharia de Grafos? Como a IA Trabalha em Equipe para Fazer Coisas de Verdade
Um guia simples e sem jargões sobre engenharia de grafos, a ideia de 2026 de montar a IA como um mapa de etapas conectadas. Veja como os agentes de IA funcionam, por que pequenos erros se acumulam e como revisões e trabalho em equipe resolvem isso.
nbkhope
O Que É Engenharia de Loops? Como Agentes de IA Trabalham Até Terminar o Serviço
Um guia simples e sem jargões sobre engenharia de loops, a ideia de 2026 de projetar o ciclo em que um agente de IA trabalha até terminar o serviço, com objetivos claros, feedback real, regras de parada e a hora de chamar uma pessoa.
nbkhope
Comentários
Be kind and specific. Comments with links from new accounts appear after a moderator reviews them.