O que é uma rede neural? Um guia simples sobre como a IA aprende
Redes neurais aprendem padrões ajustando cálculos conectados em camadas. Acompanhe o exemplo de uma foto de gato para entender neurônios, pesos, treinamento e limites.

Nesta página
O que é uma rede neural? Um guia simples sobre como a IA aprende
Mostre milhares de fotos de gatos a um computador e peça que reconheça a próxima. Como ele poderia aprender que orelhas pontudas, bigodes e certa combinação de pixels costumam significar “gato”?
Uma resposta é a rede neural: um modelo de aprendizado de máquina formado por camadas de pequenos cálculos que aprendem padrões úteis a partir de exemplos. O nome faz referência à biologia, mas são funções matemáticas executadas por computadores — não cérebros digitais em miniatura. Vamos acompanhar uma foto pela rede e ver como o aprendizado acontece.
A rede em uma imagem
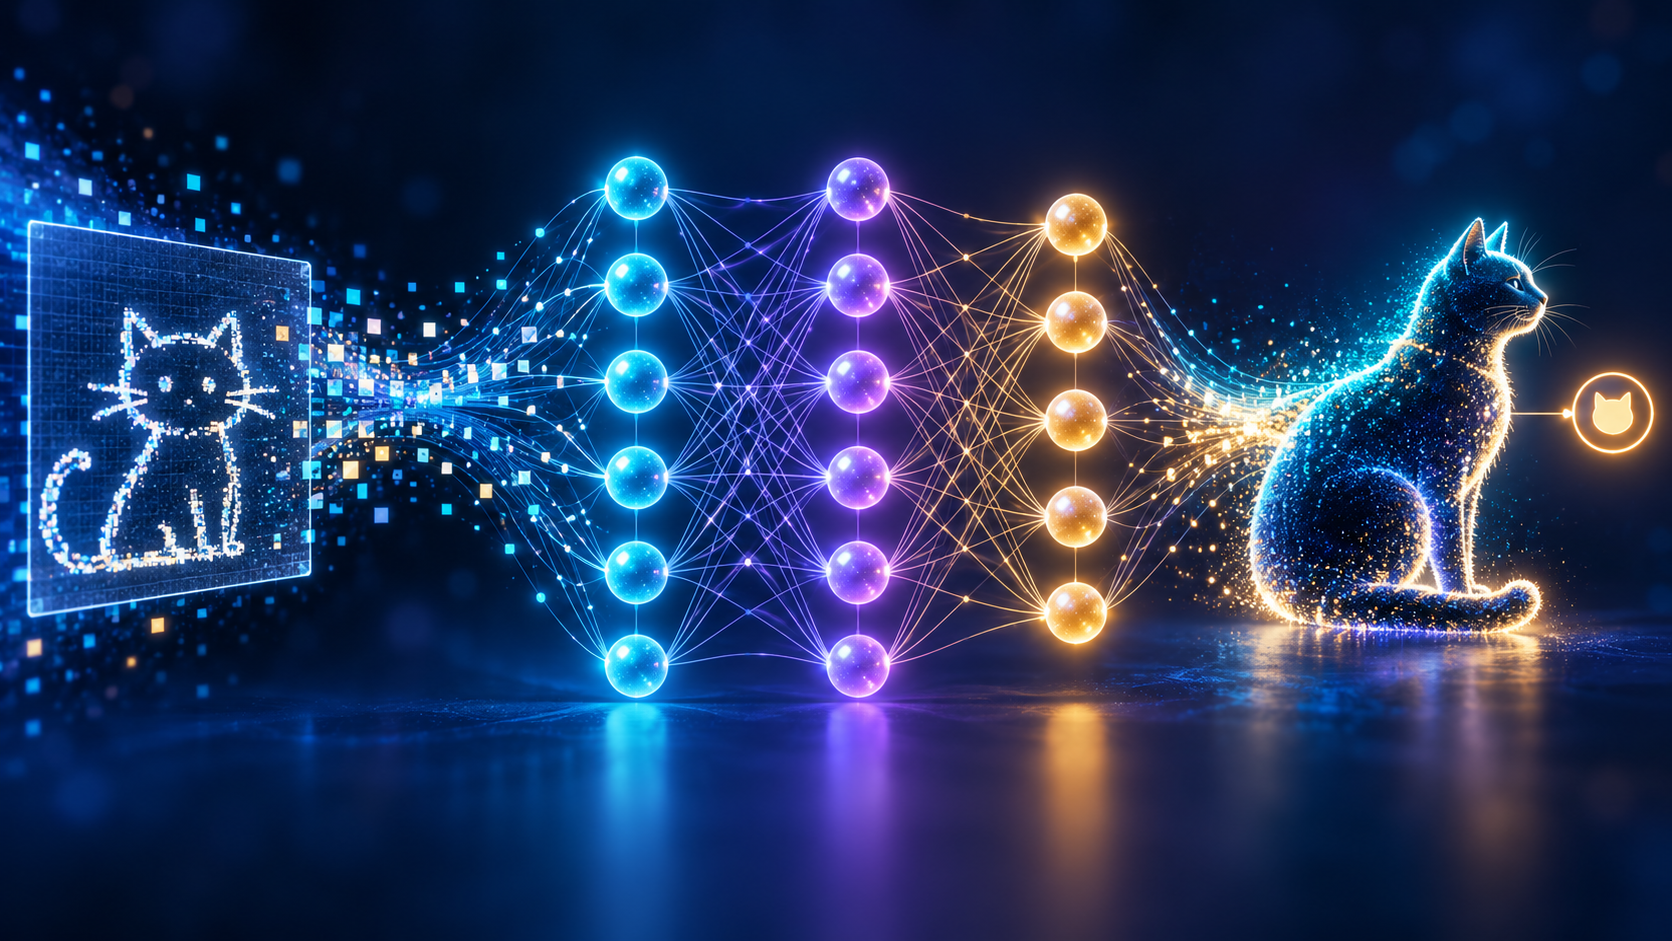
Uma rede neural recebe números como entrada, transforma-os por uma ou mais camadas ocultas e produz uma saída. As linhas entre os nós carregam pesos aprendidos; cada nó combina os valores recebidos, soma um viés e geralmente aplica uma função de ativação.
1pixels / medidas           camadas ocultas                previsão
2  x₁  ───────┐             ○───○───○
3  x₂  ───────┼────────────▶ ○───○───○ ────────────────▶  gato: 0,91
4  x₃  ───────┘             ○───○───○                    cão: 0,06
5                            atributos aprendidos          ave: 0,03
Neste desenho, os círculos são neurônios (ou unidades), e as linhas representam conexões. Um modelo de imagem real pode começar com centenas de milhares de valores de pixels e conter muito mais unidades e conexões do que caberiam nesta ilustração.
O que um neurônio realmente faz?
Pense em um neurônio como uma pequena máquina de pontuação. Ele multiplica cada entrada por um peso, soma os resultados com um viés e passa a pontuação por uma função de ativação:
pontuação = (entrada₁ × peso₁) + (entrada₂ × peso₂) + viés
saída = ativação(pontuação)
Imagine duas medidas fictícias da imagem: “sinal de orelha pontuda” (0,8) e “sinal de orelha redonda” (0,2). Com pesos 0,6 e -0,4 e viés de 0,1, temos:
pontuação = (0,8 × 0,6) + (0,2 × -0,4) + 0,1 = 0,5Com uma ativação ReLU, pontuações negativas viram zero e as positivas seguem adiante. Essa unidade envia 0,5 para a próxima camada. Ela não “entendeu orelhas”; realizou um cálculo aprendido que pode ser útil.
| Parte | Função em linguagem simples |
|---|---|
| Entrada | Os números que descrevem um exemplo, como valores de pixels |
| Peso | A intensidade com que uma conexão influencia o próximo cálculo |
| Viés | Um ajuste que desloca a pontuação do neurônio |
| Ativação | Uma função que permite à rede modelar mais do que uma grande regra linear |
| Saída | A previsão, pontuação ou resultado pedido pela tarefa |
O exemplo é propositalmente pequeno. Redes neurais reais podem ter milhões ou bilhões de parâmetros ajustáveis e muitos tipos diferentes de camadas.
Como uma rede aprende?
O treinamento é um ciclo repetido de tentativa, medição e ajuste. A rede faz uma previsão, compara com a resposta conhecida, mede o erro usando uma função de perda e então ajusta os pesos para reduzir essa perda.
1exemplo de treino + rótulo correto
2                │
3                ▼
4       previsão da rede ──▶ perda: quanto errou?
5                                  │
6                           retropropagação
7                                  │
8                        atualizar pesos e vieses
9                                  │
10                                  └──▶ tentar o próximo exemplo
Para um classificador de fotos de gatos:
- Envie uma foto rotulada: “gato”.
- A rede prevê pontuações para gato, cão e ave.
- A perda aumenta quando a pontuação de gato fica baixa ou outra categoria fica alta.
- A retropropagação calcula quanto cada peso contribuiu para aquela perda.
- Um otimizador ajusta os pesos na direção que deve reduzir a perda.
- Repita com muitos exemplos; avalie usando fotos que não participaram do treinamento.
Bibliotecas modernas, como PyTorch, calculam a matemática do cálculo diferencial automaticamente. A ideia principal é que os pesos internos da rede são ajustados com base no retorno recebido. Ela não guarda uma regra escrita à mão como “se tem bigodes, é gato”.
Por que empilhar camadas?
Cada camada pode transformar suas entradas em uma representação mais útil. Em um modelo de imagens, os primeiros cálculos podem responder a bordas simples ou mudanças de cor; camadas posteriores podem combinar sinais em formas e partes; outras podem ajudar na previsão final da tarefa. É uma intuição, não uma garantia de que cada neurônio tenha um significado claro para uma pessoa.
Uma rede com várias camadas ocultas é chamada de profunda. Aprendizado profundo é a área do aprendizado de máquina que usa essas redes neurais mais profundas. Diferentes arquiteturas atendem a dados e tarefas distintas:
| Arquitetura | Uso comum | Uma imagem para ajudar |
|---|---|---|
| Rede feed-forward | Tabelas e classificação básica | Sinais avançam camada por camada até a saída |
| Rede convolucional (CNN) | Imagens e padrões espaciais | Filtros percorrem padrões visuais locais |
| Transformer | Texto, código, imagens, áudio e mais | Atenção ajuda a relacionar partes da entrada |
| Rede recorrente (RNN) | Sequências ordenadas, especialmente em sistemas mais antigos | Um estado carrega informação de etapas anteriores |
Este é um mapa, não um manual rígido. Sistemas modernos podem combinar arquiteturas e usar componentes especializados em tarefas específicas.
Onde encontramos redes neurais?
Elas ajudam a viabilizar reconhecimento de fala, tradução, classificação de imagens, sistemas de recomendação, modelagem científica e IA generativa. Um grande modelo de linguagem, por exemplo, é construído com uma arquitetura de rede neural — a maioria dos LLMs atuais usa Transformers —, mas a família das redes neurais é muito maior do que os chatbots.
A mesma ideia básica apoia tarefas bem diferentes. Uma rede pode classificar uma foto, estimar um número, ordenar resultados de busca ou gerar o próximo token de uma sequência. Entradas, saídas, dados de treinamento, objetivo e arquitetura fazem diferença.
No que redes neurais são boas — e o que pode dar errado
Redes neurais aprendem padrões complexos que seriam difíceis de escrever como uma lista de regras fixas. Essa flexibilidade é poderosa, mas também significa que elas dependem dos exemplos e das escolhas feitas no treinamento.
- Podem decorar os exemplos. Um modelo pode memorizar peculiaridades dos dados de treino e se sair mal com novos casos. Separe dados de teste e avalie exemplos que ele nunca viu.
- A qualidade dos dados importa. Exemplos ausentes, ruidosos ou pouco representativos podem resultar em previsões pouco confiáveis ou desempenho desigual entre grupos.
- Podem ser difíceis de interpretar. Uma previsão correta não explica automaticamente por que a rede chegou àquele resultado.
- Podem exigir muito processamento. Treinar modelos grandes pode consumir bastante tempo, hardware especializado e energia.
- Uma pontuação não é certeza. Uma pontuação alta não garante que a previsão seja correta, justa ou calibrada para uma decisão do mundo real.
Uma rede neural é uma ferramenta para aprender padrões, não um detector da verdade. Para decisões importantes, avalie-a com cuidado e mantenha pessoas responsáveis pela forma como ela é usada.
Experimente a ideia
O curso Machine Learning Crash Course do Google tem lições interativas sobre nós, camadas ocultas, funções de ativação e treinamento de redes neurais. Se quiser ver o ciclo de aprendizado no código, o material para iniciantes do PyTorch apresenta um fluxo completo, incluindo diferenciação automática e otimização.
Enquanto explora, use esta pequena lista:
- Quais são os números de entrada?
- O que o modelo deve prever?
- Quais exemplos vão ensiná-lo?
- Como você vai avaliá-lo com exemplos que ainda não viu?
- Quais erros seriam mais importantes?
Quando souber responder, “rede neural” deixa de parecer um cérebro misterioso dentro de uma caixa. Ela passa a ser uma calculadora em camadas que aprende quais padrões ajudam a resolver determinada tarefa.
Fontes e leituras adicionais
- Google para Desenvolvedores: Redes neurais — nós, camadas ocultas, funções de ativação e treinamento.
- Google para Desenvolvedores: Retropropagação — como gradientes de erro orientam ajustes de pesos e quais problemas podem surgir no treino.
- PyTorch: Aprenda os fundamentos — fluxo completo de aprendizado de máquina para iniciantes, atualizado em 2026.
- PyTorch: Redes neurais — definição de um modelo e procedimento típico de treinamento.
- Goodfellow, Bengio e Courville: Deep Learning — livro detalhado e gratuito sobre matemática e arquiteturas do aprendizado profundo.
Read next
O Que É o Meta Muse? Um Guia dos Modelos e Ferramentas de IA da Meta
Meta Muse é uma família de modelos e produtos de IA da Meta, que inclui o assistente Meta AI, raciocínio multimodal, ferramentas criativas e agentes para desenvolvedores. Entenda o que esse nome abrange e o que saber sobre os modelos mais recentes.
 nbkhope
O Que É um Transformer na IA? A Ideia por Trás do ChatGPT, Explicada de Forma Simples
Um guia simples e sem jargões sobre os transformers, a arquitetura de IA por trás do ChatGPT, do Claude e do Gemini. Entenda como a "atenção" ajuda a IA a entender palavras no contexto e por que isso mudou a IA tão rápido.
nbkhope
O Que É Aprendizado por Reforço? Como a IA Aprende com Tentativa, Erro e Recompensa
Uma introdução simples e sem jargões ao aprendizado por reforço, o jeito como a IA aprende com tentativa, erro e recompensa, como um cachorro aprendendo com petiscos. Veja um robô aprender um labirinto e como isso molda os chatbots.
nbkhope
Comentários
Be kind and specific. Comments with links from new accounts appear after a moderator reviews them.