O Que É Visão Computacional? Como Computadores Aprendem a Enxergar
Uma introdução simples e sem jargões à visão computacional, a IA que permite aos computadores entender fotos e vídeos. Veja como o computador enxerga uma imagem como números, por que enxergar é difícil e onde você já usa isso.

Nesta página
O seu celular desbloqueia quando vê o seu rosto. O aplicativo de fotos encontra todas as imagens da praia quando você digita "praia". O carro apita quando você sai da faixa. O aplicativo do banco lê o código de barras de um boleto que você fotografou. Nenhum desses aparelhos tem olhos como os seus, mas todos "enxergam".
Isso é visão computacional: a parte da inteligência artificial que ensina computadores a entender imagens e vídeos. É um dos sonhos mais antigos da computação, e, na última década, ela passou de quase não funcionar a estar em todo lugar.
Este artigo explica a visão computacional em linguagem simples: como um computador olha para uma imagem, por que enxergar é surpreendentemente difícil, o que a IA de visão consegue fazer e onde você já a usa todo dia.
O que é visão computacional?
Visão computacional é a área que ensina computadores a tirar informações úteis de imagens e vídeos: reconhecer o que há numa foto, achar onde as coisas estão, ler textos, acompanhar movimentos e muito mais.
Para você, enxergar parece não exigir esforço nenhum. Você bate o olho numa sala e sabe na hora que há um gato no sofá, uma xícara na mesa e alguém na porta. Mas essa facilidade esconde uma quantidade enorme de trabalho que o seu cérebro faz sem você perceber. Ensinar um computador a fazer o mesmo acabou sendo um dos problemas mais difíceis da IA.
Tem até uma história famosa de 1966, quando um professor do MIT, nos Estados Unidos, criou um "projeto de visão de verão", esperando que alunos avançassem de verdade em fazer um computador reconhecer objetos em uma única temporada de férias. A área inteira levou mais uns cinquenta anos para chegar lá.
Como um computador "vê" uma imagem
A primeira surpresa: o computador não vê imagem nenhuma. Ele vê números.
Toda imagem digital é uma grade de quadradinhos chamados pixels. Numa imagem em preto e branco, cada pixel é só um número que indica o brilho, normalmente de 0 (preto) a 255 (branco):
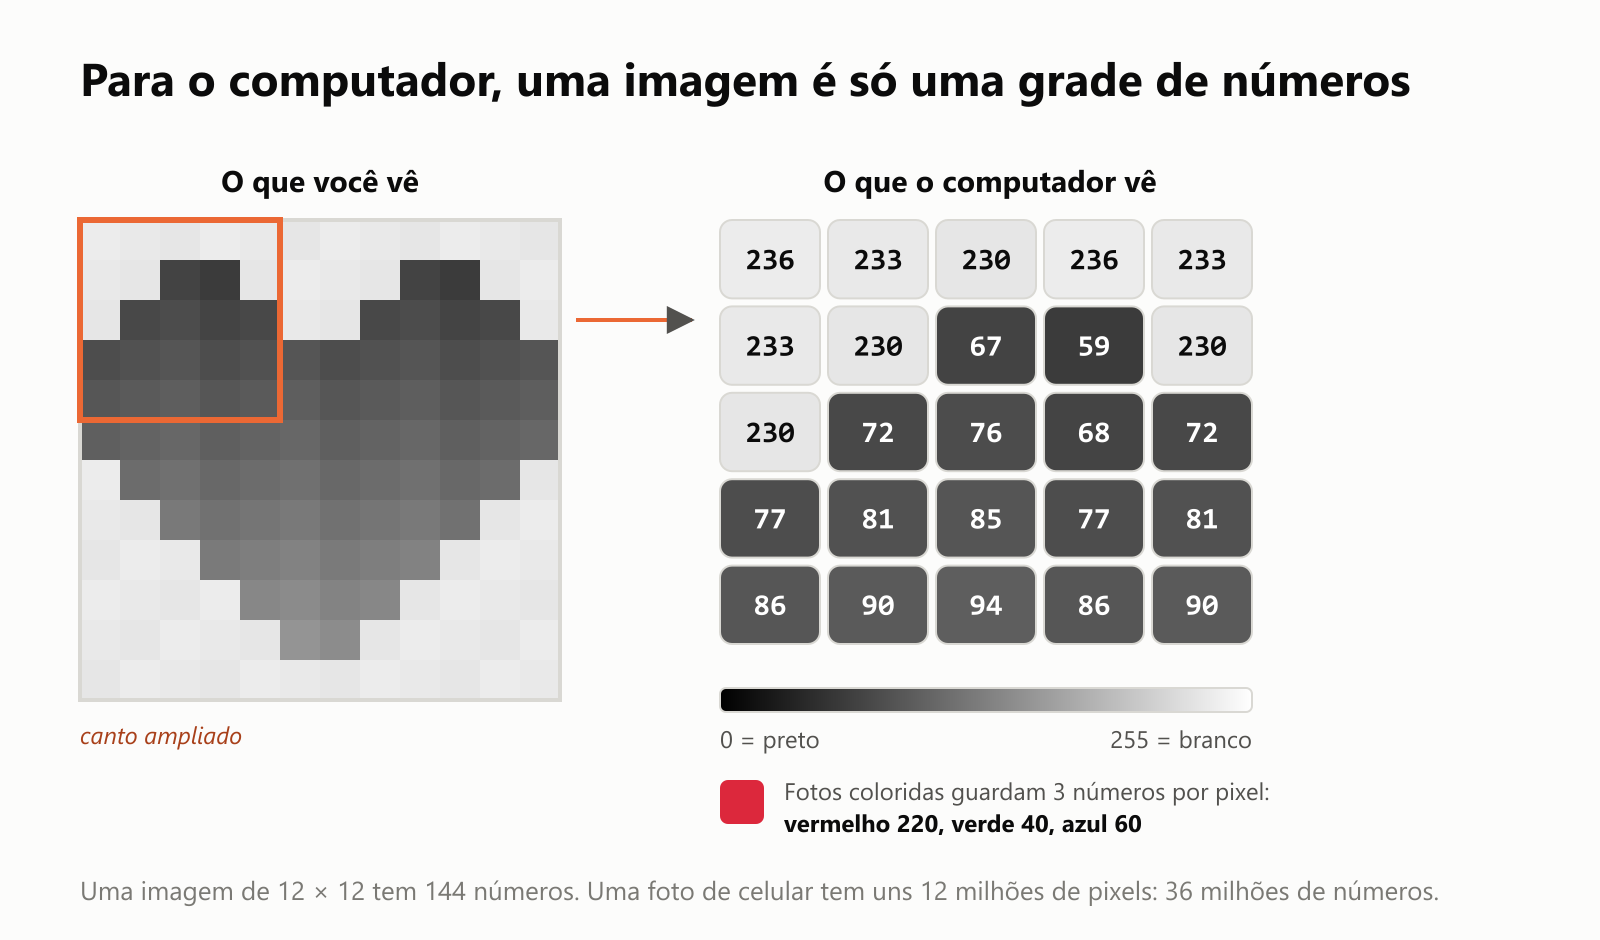
Imagens coloridas guardam três números por pixel: quanto de luz vermelha, verde e azul misturar. Uma foto típica de celular tem uns 12 milhões de pixels, ou seja, cerca de 36 milhões de números.
Então, quando dizemos que um computador "olha" uma foto, o que ele recebe de verdade é uma planilha gigante de números. O grande desafio da visão computacional é sair desses números e chegar a uma ideia como "isso é um cachorro".
Por que enxergar é tão difícil para um computador
Pense em tudo o que pode mudar num mesmo objeto:
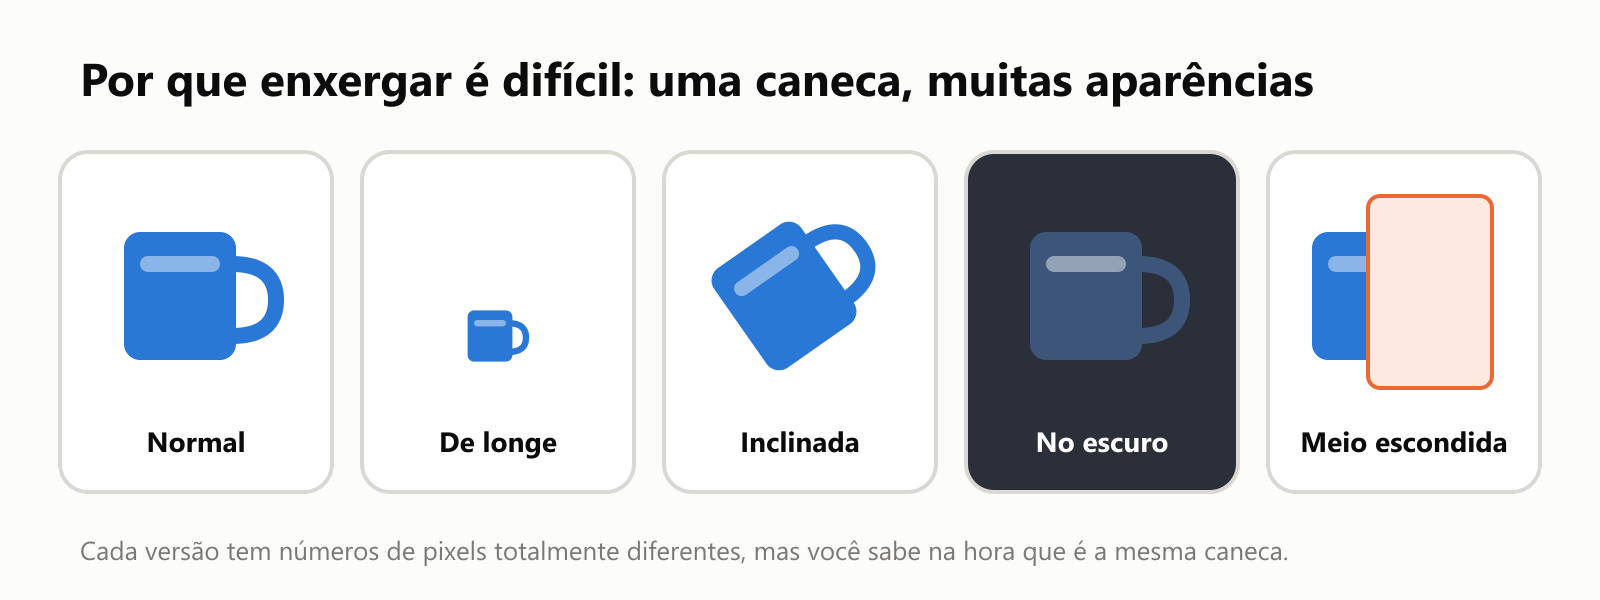
Cada uma dessas cinco imagens gera um conjunto totalmente diferente de números de pixels. Mesmo assim, você sabe na hora que é a mesma caneca. O computador precisa aprender a ignorar todas as mudanças que não importam, como tamanho, ângulo, iluminação, fundo ou algo tapando a visão, e prestar atenção nas que importam.
E isso é só uma caneca. Agora imagine diferenciar centenas de raças de cachorro, ler uma letra de mão bagunçada ou perceber um pedestre descendo da calçada à noite, na chuva.
Um primeiro passo: achar as bordas
Antes do boom da IA, boa parte da visão computacional eram truques engenhosos criados à mão. Um dos mais básicos, e ainda útil, é a detecção de bordas.
A ideia é simples: comparar cada pixel com os vizinhos. Onde o brilho muda de repente, provavelmente há o contorno de alguma coisa. Veja um detector de bordas de verdade (um método clássico chamado filtro de Sobel) rodando num pequeno desenho de uma casa:
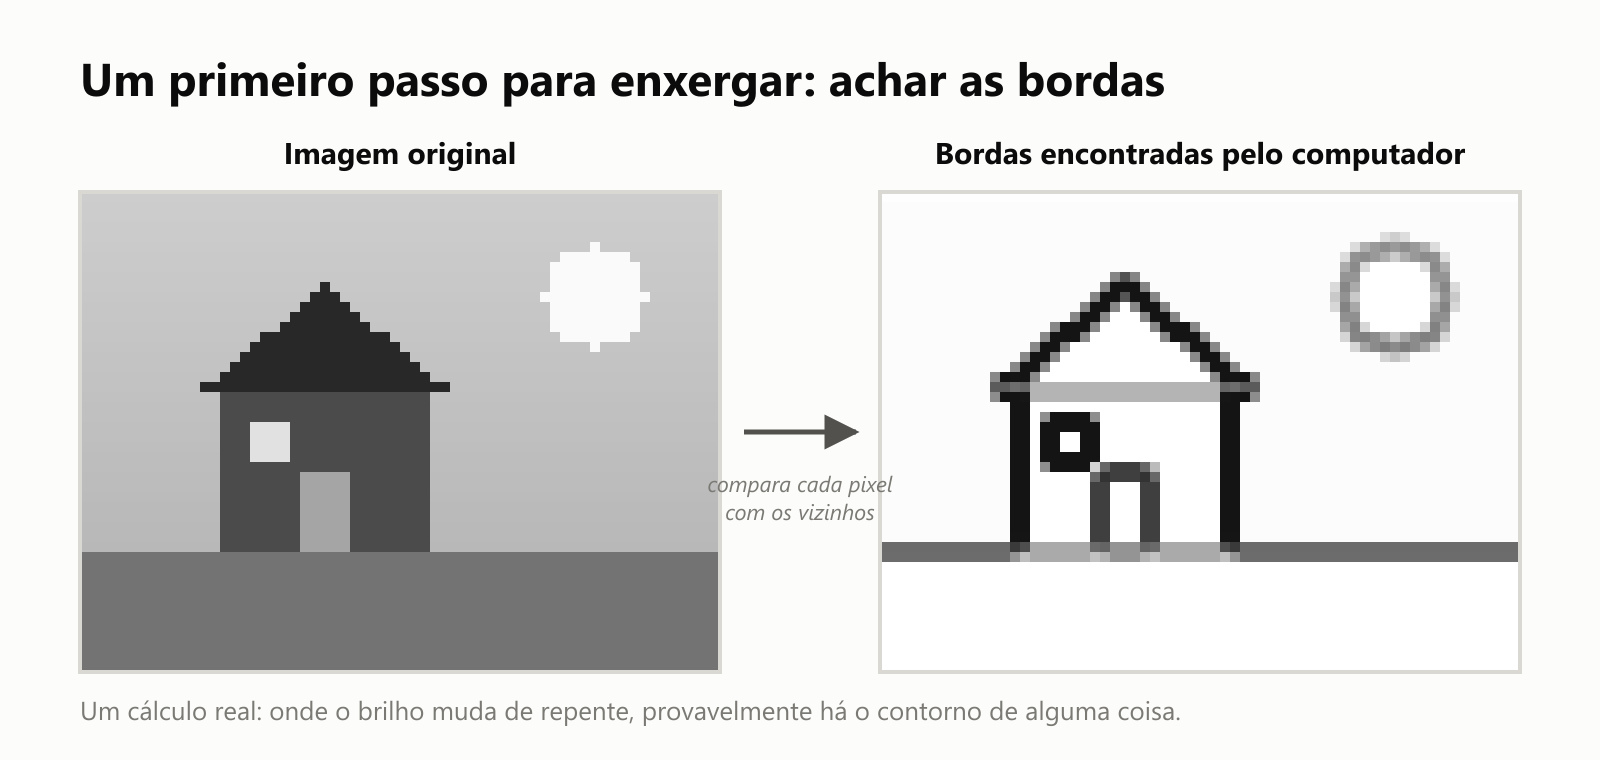
A partir de uma grade de números, o computador encontrou os contornos do telhado, das paredes, da porta, da janela e do sol. Contornos são um grande passo para reconhecer formas. Aliás, quando pesquisadores olham por dentro dos sistemas modernos de visão com aprendizado profundo, as primeiras camadas aprendem a encontrar bordas como essas sozinhas.
De regras feitas à mão a aprender com milhões de fotos
Durante décadas, pesquisadores tentaram descrever objetos com regras: "um rosto tem dois olhos escuros acima de um nariz, acima de uma boca". Esses sistemas funcionavam em condições arrumadinhas de laboratório e falhavam no mundo real, bagunçado.
A virada veio de aprender em vez de seguir regras. Em 2009, uma equipe liderada pela pesquisadora Fei-Fei Li lançou o ImageNet, uma coleção com mais de 14 milhões de fotos identificadas por pessoas. Com tantos dados, computadores mais rápidos e redes neurais profundas, os sistemas de visão finalmente puderam aprender como as coisas são a partir de exemplos. Em 2012, um sistema de aprendizado profundo chamado AlexNet superou de longe todos os outros métodos em reconhecer objetos em fotos, e começou a era moderna da visão computacional.
Os modelos de visão de hoje aprendem do mesmo jeito: você mostra uma quantidade enorme de imagens identificadas ("isto é um gato", "esta caixa é um carro", "estes pixels são a rua"), e eles vão aprendendo os padrões, das bordas às formas e aos objetos inteiros.
O que a visão computacional consegue fazer
A IA de visão consegue responder perguntas sobre uma imagem em níveis diferentes de detalhe. Estes são os três mais comuns:
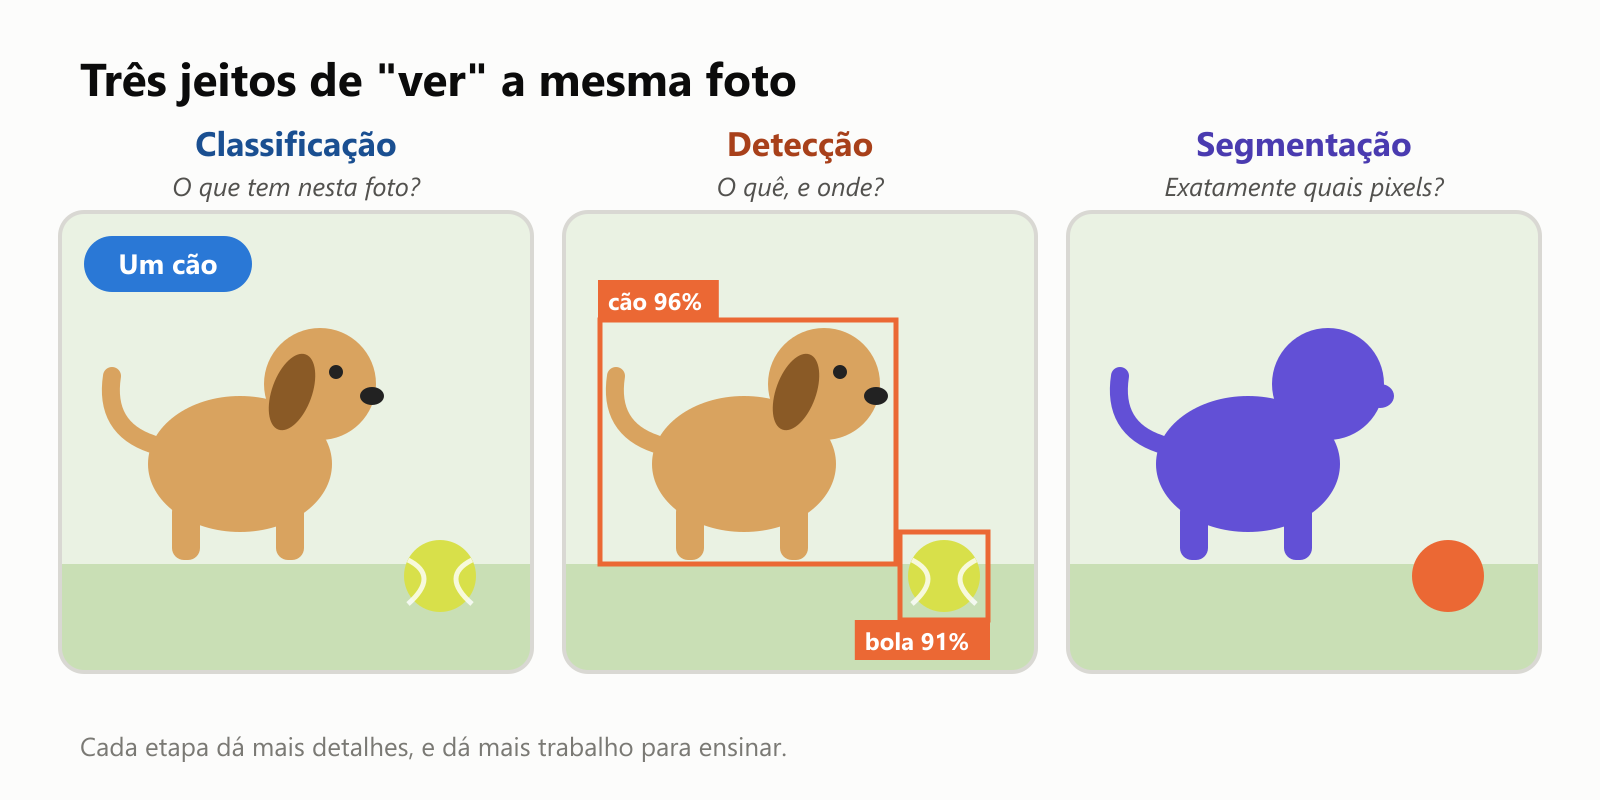
- Classificação: "Do que é esta foto?" Uma resposta para a imagem inteira: um cão.
- Detecção de objetos: "O que tem nela, e onde?" Uma caixa em volta de cada coisa, com um rótulo: cão aqui, bola ali. É isso que permite a um carro encontrar cada pedestre e cada outro carro.
- Segmentação: "Exatamente quais pixels pertencem a quê?" O contorno preciso de cada coisa. É assim que as videochamadas desfocam o seu fundo, mas não você, e que programas médicos contornam um órgão num exame.
E tem muito mais:
- Reconhecimento facial: associar um rosto a uma pessoa conhecida, como no desbloqueio do celular.
- Reconhecimento de texto (OCR): ler textos impressos ou escritos à mão em imagens, como ao escanear um recibo ou um boleto.
- Estimativa de pose: encontrar a posição do corpo de uma pessoa, usada em aplicativos de exercício e em captura de movimento.
- Rastreamento: acompanhar objetos de um quadro do vídeo para o outro, usado em replays de esporte e câmeras de trânsito.
- Geração de imagens: o caminho inverso, criar imagens novas a partir de uma descrição em texto.
Um modelo de visão ordena os palpites
Um modelo de visão nunca simplesmente "sabe" o que há numa imagem. Ele calcula a chance de cada resposta possível e as coloca em ordem:
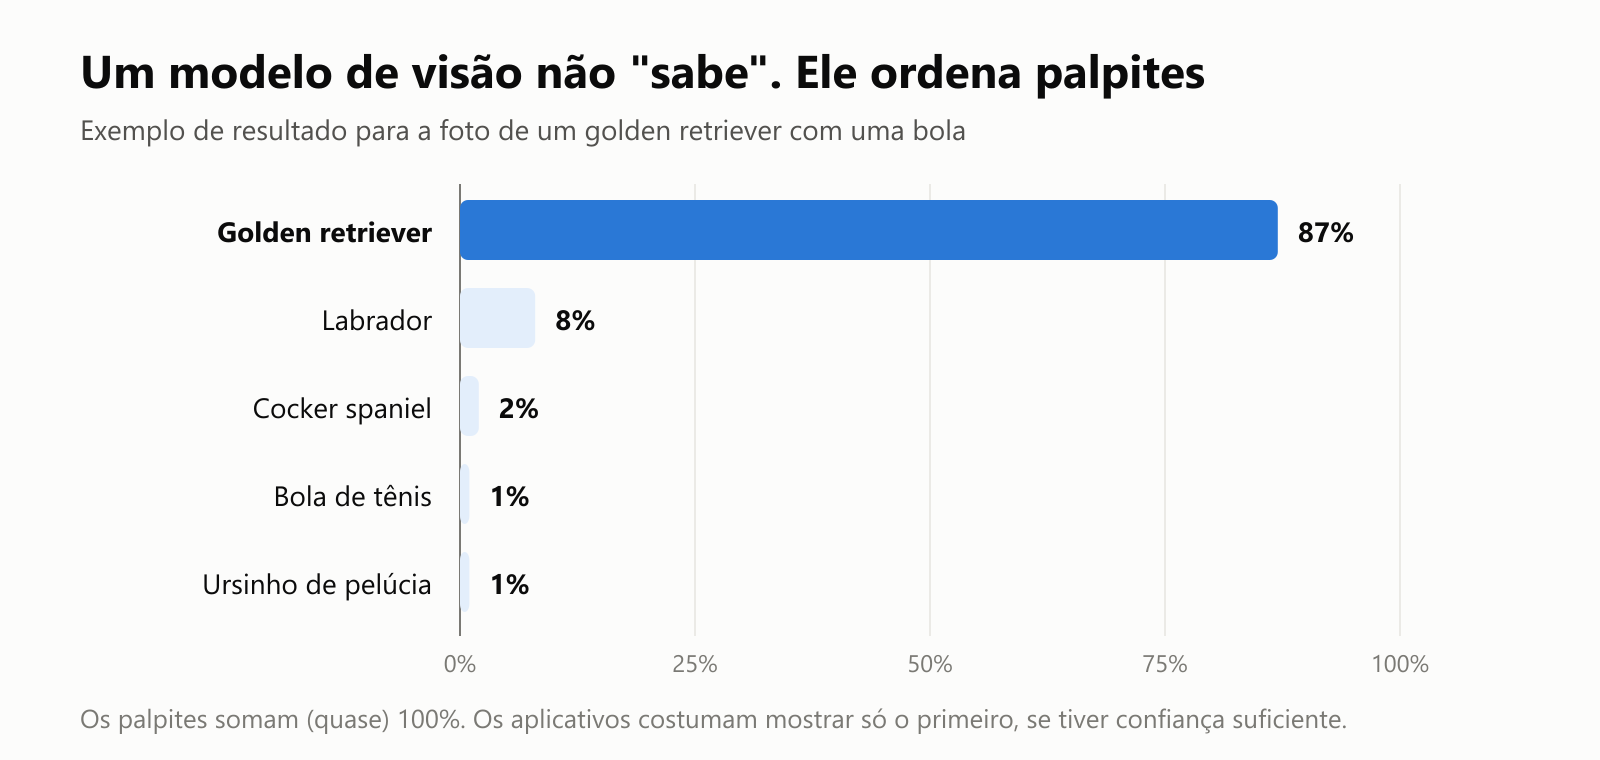
Repare que a segunda opção do modelo é outra raça de cachorro parecida. Isso é comum: os erros dele costumam ser confusões "razoáveis". Os aplicativos normalmente mostram só o primeiro palpite, e só quando o modelo tem confiança suficiente. Quando não tem, um bom aplicativo pede para você ou uma pessoa conferir.
Onde você encontra visão computacional todo dia
| Onde | O que a visão computacional faz |
|---|---|
| No celular | Desbloqueio facial, desfoque do modo retrato, busca de fotos por "cachorro" ou "praia", leitura de QR codes |
| No carro | Manter-se na faixa, ler placas de velocidade, frenagem automática de emergência, câmeras de estacionamento |
| Táxis sem motorista | Detectar e acompanhar carros, ciclistas e pedestres em volta do veículo |
| Nas compras | Caixas de autoatendimento, buscar produtos por foto |
| No banco | Ler boletos e códigos pela câmera, conferir se um documento combina com o seu rosto |
| Na saúde | Ajudar médicos a encontrar sinais de doenças em raios-X, tomografias e fotos do olho ou da pele |
| No campo | Encontrar plantas doentes e ervas daninhas com drones ou câmeras em tratores |
| Nas fábricas | Pegar defeitos em produtos enquanto passam pela linha de produção |
| Acessibilidade | Aplicativos que descrevem uma cena, leem um cardápio ou identificam cédulas para pessoas cegas ou com baixa visão |
Os limites e as preocupações
A visão computacional é poderosa, mas está longe de ser perfeita:
- Condições incomuns: neblina, reflexos, escuridão, ângulos estranhos ou coisas que ela nunca viu no treinamento podem confundi-la.
- Ela pode ser enganada: pesquisadores mostraram que alguns adesivos bem colocados numa placa de "pare" podem fazer certos sistemas de visão lerem a placa errado. Mudanças que não significam nada para uma pessoa podem significar muito para um modelo.
- Viés: um modelo só é tão bom quanto as fotos com que foi treinado. Um estudo de 2019 do Instituto Nacional de Padrões e Tecnologia dos Estados Unidos (NIST) encontrou muitos sistemas de reconhecimento facial que erravam mais com alguns grupos demográficos do que com outros.
- Privacidade: câmeras com reconhecimento facial podem rastrear pessoas em lugares públicos sem que elas saibam. Muitas cidades, países e empresas debatem onde traçar o limite, e alguns já restringiram o uso.
Um pequeno glossário
- Visão computacional: ensinar computadores a entender imagens e vídeos.
- Pixel: um quadradinho de uma imagem digital, guardado como números.
- RGB: os três números por pixel de uma imagem colorida: vermelho, verde e azul (red, green, blue).
- Detecção de bordas: encontrar lugares onde o brilho muda de repente, geralmente os contornos dos objetos.
- Classificação: dizer o que há numa imagem inteira.
- Detecção de objetos: encontrar cada objeto e desenhar uma caixa em volta dele.
- Segmentação: marcar cada pixel com aquilo a que ele pertence.
- OCR (reconhecimento óptico de caracteres): ler textos a partir de imagens.
- Reconhecimento facial: identificar ou confirmar uma pessoa pelo rosto.
- ImageNet: uma coleção famosa com mais de 14 milhões de fotos identificadas, que ajudou a dar a largada na visão computacional moderna.
- Nível de confiança: o quanto um modelo tem certeza de uma resposta, muitas vezes mostrado como porcentagem.
Concluindo
Para um computador, uma imagem é só uma grade de números. A visão computacional é a arte de transformar esses números em compreensão: bordas, depois formas, depois objetos, depois cenas inteiras. Depois de décadas de progresso lento com regras feitas à mão, aprender com milhões de fotos identificadas finalmente fez tudo funcionar, e hoje ela está no seu bolso, no seu carro e no consultório do seu médico.
Ela ainda tem pontos cegos, de iluminação estranha a erros injustos, e levanta questões reais sobre privacidade. Mas, da próxima vez que o seu celular encontrar na hora todas as fotos do seu cachorro, você vai saber o que está acontecendo: milhões de números, muitos padrões aprendidos e uma lista ordenada de palpites com "cachorro" bem lá no topo.
Read next
O Que É Aprendizado por Reforço? Como a IA Aprende com Tentativa, Erro e Recompensa
Uma introdução simples e sem jargões ao aprendizado por reforço, o jeito como a IA aprende com tentativa, erro e recompensa, como um cachorro aprendendo com petiscos. Veja um robô aprender um labirinto e como isso molda os chatbots.
 nbkhope
O Que É Engenharia de Grafos? Como a IA Trabalha em Equipe para Fazer Coisas de Verdade
Um guia simples e sem jargões sobre engenharia de grafos, a ideia de 2026 de montar a IA como um mapa de etapas conectadas. Veja como os agentes de IA funcionam, por que pequenos erros se acumulam e como revisões e trabalho em equipe resolvem isso.
nbkhope
O Que É Engenharia de Loops? Como Agentes de IA Trabalham Até Terminar o Serviço
Um guia simples e sem jargões sobre engenharia de loops, a ideia de 2026 de projetar o ciclo em que um agente de IA trabalha até terminar o serviço, com objetivos claros, feedback real, regras de parada e a hora de chamar uma pessoa.
nbkhope
Comentários
Be kind and specific. Comments with links from new accounts appear after a moderator reviews them.